<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://www.wangyiyang.cc/feed.xml" rel="self" type="application/atom+xml" /><link href="https://www.wangyiyang.cc/" rel="alternate" type="text/html" /><updated>2026-07-29T21:03:40+08:00</updated><id>https://www.wangyiyang.cc/feed.xml</id><title type="html">翊行代码</title><subtitle>王翊仰的技术博客，专注 AI 编程、Agent 架构、MCP 协议与开源工具</subtitle><author><name>王翊仰</name></author><entry><title type="html">回测最大的风险，是写出一个会骗人的回测器</title><link href="https://www.wangyiyang.cc/2026/07/29/backtest-honest/" rel="alternate" type="text/html" title="回测最大的风险，是写出一个会骗人的回测器" /><published>2026-07-29T00:00:00+08:00</published><updated>2026-07-29T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/29/backtest-honest</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/29/backtest-honest/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-29-backtest-honest/01.png" alt="" /></p>

<blockquote>
  <p>AI 量化学习笔记 · 第 4 篇</p>
</blockquote>

<p>研究环境跑通之后，下一步自然是回测。但我得先泼自己一盆冷水：最危险的情况，是写出一个<strong>会骗人的</strong>回测器。曲线很漂亮，逻辑里却藏着未来函数或不切实际的成本假设；等到实盘发现，学费已经交了。</p>

<p>这篇先不讨论策略能赚多少。我只搭一个自己能逐笔核对的简易回测器，再配一套固定检验清单。</p>

<h2 id="为什么不直接用-backtrader">为什么不直接用 backtrader</h2>

<p>backtrader、<code class="language-plaintext highlighter-rouge">vn.py</code> 这类框架当然成熟，但对我现在的阶段有两个问题。</p>

<p>一是黑箱。框架替你处理了成交假设、费用和撮合细节，恰恰是这些细节最容易骗人。用别人的默认值，等于把最危险的假设交给了不了解的代码。</p>

<p>二是过重。我的第一阶段目标是 4—6 只宽基 ETF 的月度轮动，每月调仓一次，计算量很小。为它引入一整个事件驱动框架，会增加当前阶段不需要的工程复杂度。</p>

<p>自己写一个两三百行的简易回测器，每个假设都摆在明面上，这才是这个阶段该做的事。等策略复杂到自己写不动，再换框架不迟。</p>

<h2 id="五层结构">五层结构</h2>

<p>回测器按学习大纲拆成五层，每层只做一件事：</p>

<ol>
  <li>数据层：价格、复权因子、交易日历、标的信息。上一篇已经就绪。</li>
  <li>信号层：策略在收盘后用当天及之前的数据生成信号。这一层的铁律是：不许碰未来的数据。</li>
  <li>组合层：把信号翻译成目标仓位，包括持有几只、各占多少、留多少现金和单标的上限。</li>
  <li>成交层：信号在下一交易日成交，扣佣金和滑点。所有「今天收盘看信号、今天收盘价买入」的写法都是自欺。</li>
  <li>绩效层：净值、年化、最大回撤、夏普、换手率、费用，以及全部交易明细。</li>
</ol>

<p>当前两个基线都只有一个标的，所以组合层暂时收敛成一列 <code class="language-plaintext highlighter-rouge">target_weight</code>，直接表达 0 到 1 之间的目标仓位。等进入多 ETF 轮动，再把组合层拆成独立模块。胜率也暂时不算：按交易、按持仓周期还是按交易日计算，含义完全不同，在口径明确前不放一个容易误导的数字。</p>

<p>五层之间靠两个约定连接：<strong>信号只能由 T 日及以前的数据决定</strong>，<strong>T 日信号只在 T+1 生效</strong>。约束要落进代码和测试，不能只留在注释里。</p>

<p>数据层沿用上一篇的 <code class="language-plaintext highlighter-rouge">load_daily</code>，直接从 DuckDB 读取后复权日线。仓库版本会校验价格、日期顺序和窗口参数；这些属于防御性代码，正文只保留信号如何生成：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># src/backtest/signals.py（核心逻辑）
</span><span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>


<span class="k">def</span> <span class="nf">sma_cross</span><span class="p">(</span><span class="n">df</span><span class="p">:</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">,</span> <span class="n">fast</span><span class="p">:</span> <span class="nb">int</span> <span class="o">=</span> <span class="mi">20</span><span class="p">,</span> <span class="n">slow</span><span class="p">:</span> <span class="nb">int</span> <span class="o">=</span> <span class="mi">60</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">pd</span><span class="p">.</span><span class="n">Series</span><span class="p">:</span>
    <span class="n">fast_ma</span> <span class="o">=</span> <span class="n">df</span><span class="p">[</span><span class="s">"close"</span><span class="p">].</span><span class="n">rolling</span><span class="p">(</span><span class="n">fast</span><span class="p">).</span><span class="n">mean</span><span class="p">()</span>
    <span class="n">slow_ma</span> <span class="o">=</span> <span class="n">df</span><span class="p">[</span><span class="s">"close"</span><span class="p">].</span><span class="n">rolling</span><span class="p">(</span><span class="n">slow</span><span class="p">).</span><span class="n">mean</span><span class="p">()</span>
    <span class="k">return</span> <span class="p">(</span><span class="n">fast_ma</span> <span class="o">&gt;</span> <span class="n">slow_ma</span><span class="p">).</span><span class="n">astype</span><span class="p">(</span><span class="nb">float</span><span class="p">).</span><span class="n">rename</span><span class="p">(</span><span class="s">"target_weight"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">buy_and_hold</span><span class="p">(</span><span class="n">df</span><span class="p">:</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">pd</span><span class="p">.</span><span class="n">Series</span><span class="p">:</span>
    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="n">Series</span><span class="p">(</span><span class="mf">1.0</span><span class="p">,</span> <span class="n">index</span><span class="o">=</span><span class="n">df</span><span class="p">.</span><span class="n">index</span><span class="p">,</span> <span class="n">name</span><span class="o">=</span><span class="s">"target_weight"</span><span class="p">)</span>
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">rolling</code> 只使用当前行和之前的值。测试里还会修改未来价格，确认过去的信号完全不变。风险更容易出现在信号接到价格的那一步，所以成交层统一执行一次显式的 <code class="language-plaintext highlighter-rouge">shift(1)</code>。</p>

<h2 id="成交层t1成本和可买数量">成交层：T+1、成本和可买数量</h2>

<p>第一版示例里有一个很隐蔽的问题：先按收盘价算满仓份数，再加滑点和佣金，可能让现金变成负数。真实订单不可能借出这笔不存在的钱。修正版会把滑点、最低佣金和整手约束一起纳入最大可买数量。</p>

<p>另一个细节是逐笔复现。成交价保留 6 位小数，佣金和现金按分取整；CSV 里的 <code class="language-plaintext highlighter-rouge">shares</code>、<code class="language-plaintext highlighter-rouge">fill</code>、<code class="language-plaintext highlighter-rouge">fee</code> 和 <code class="language-plaintext highlighter-rouge">cash_after</code> 可以直接用计算器复算。</p>

<p>仓库里的成交模块还包含完整的参数校验、空交易表结构和错误信息。正文只展开三件会改变结果的事：T+1、成交成本和现金约束。</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># src/backtest/engine.py（核心逻辑）
</span><span class="kn">from</span> <span class="nn">dataclasses</span> <span class="kn">import</span> <span class="n">dataclass</span>
<span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>


<span class="o">@</span><span class="n">dataclass</span><span class="p">(</span><span class="n">frozen</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">class</span> <span class="nc">Costs</span><span class="p">:</span>
    <span class="n">commission</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">0.0003</span>
    <span class="n">min_commission</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">5.0</span>
    <span class="n">slippage</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">0.001</span>


<span class="k">def</span> <span class="nf">trade_fee</span><span class="p">(</span><span class="n">shares</span><span class="p">,</span> <span class="n">fill</span><span class="p">,</span> <span class="n">costs</span><span class="p">):</span>
    <span class="k">return</span> <span class="nb">round</span><span class="p">(</span><span class="nb">max</span><span class="p">(</span><span class="nb">abs</span><span class="p">(</span><span class="n">shares</span><span class="p">)</span> <span class="o">*</span> <span class="n">fill</span> <span class="o">*</span> <span class="n">costs</span><span class="p">.</span><span class="n">commission</span><span class="p">,</span>
                     <span class="n">costs</span><span class="p">.</span><span class="n">min_commission</span><span class="p">),</span> <span class="mi">2</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">affordable_buy</span><span class="p">(</span><span class="n">cash</span><span class="p">,</span> <span class="n">desired</span><span class="p">,</span> <span class="n">fill</span><span class="p">,</span> <span class="n">costs</span><span class="p">,</span> <span class="n">lot</span><span class="o">=</span><span class="mi">100</span><span class="p">):</span>
    <span class="n">shares</span> <span class="o">=</span> <span class="n">desired</span>
    <span class="k">while</span> <span class="n">shares</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
        <span class="k">if</span> <span class="n">shares</span> <span class="o">*</span> <span class="n">fill</span> <span class="o">+</span> <span class="n">trade_fee</span><span class="p">(</span><span class="n">shares</span><span class="p">,</span> <span class="n">fill</span><span class="p">,</span> <span class="n">costs</span><span class="p">)</span> <span class="o">&lt;=</span> <span class="n">cash</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">shares</span>
        <span class="n">shares</span> <span class="o">-=</span> <span class="n">lot</span>
    <span class="k">return</span> <span class="mi">0</span>


<span class="k">def</span> <span class="nf">run_backtest</span><span class="p">(</span><span class="n">df</span><span class="p">,</span> <span class="n">signal</span><span class="p">,</span> <span class="n">costs</span><span class="o">=</span><span class="n">Costs</span><span class="p">(),</span> <span class="n">init_cash</span><span class="o">=</span><span class="mi">100_000</span><span class="p">,</span> <span class="n">lot</span><span class="o">=</span><span class="mi">100</span><span class="p">):</span>
    <span class="n">target</span> <span class="o">=</span> <span class="n">signal</span><span class="p">.</span><span class="n">shift</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">fill_value</span><span class="o">=</span><span class="mf">0.0</span><span class="p">)</span>  <span class="c1"># T 日信号，T+1 生效
</span>    <span class="n">cash</span><span class="p">,</span> <span class="n">shares</span> <span class="o">=</span> <span class="nb">float</span><span class="p">(</span><span class="n">init_cash</span><span class="p">),</span> <span class="mi">0</span>
    <span class="n">equity</span><span class="p">,</span> <span class="n">trades</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>

    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">row</span> <span class="ow">in</span> <span class="nb">enumerate</span><span class="p">(</span><span class="n">df</span><span class="p">.</span><span class="n">itertuples</span><span class="p">(</span><span class="n">index</span><span class="o">=</span><span class="bp">False</span><span class="p">)):</span>
        <span class="n">price</span> <span class="o">=</span> <span class="nb">float</span><span class="p">(</span><span class="n">row</span><span class="p">.</span><span class="n">close</span><span class="p">)</span>
        <span class="n">nav_before</span> <span class="o">=</span> <span class="n">cash</span> <span class="o">+</span> <span class="n">shares</span> <span class="o">*</span> <span class="n">price</span>
        <span class="n">desired</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="n">nav_before</span> <span class="o">*</span> <span class="n">target</span><span class="p">.</span><span class="n">iat</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">/</span> <span class="n">price</span> <span class="o">//</span> <span class="n">lot</span><span class="p">)</span> <span class="o">*</span> <span class="n">lot</span>
        <span class="n">delta</span> <span class="o">=</span> <span class="n">desired</span> <span class="o">-</span> <span class="n">shares</span>

        <span class="k">if</span> <span class="n">delta</span><span class="p">:</span>
            <span class="n">fill</span> <span class="o">=</span> <span class="nb">round</span><span class="p">(</span><span class="n">price</span> <span class="o">*</span> <span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="n">costs</span><span class="p">.</span><span class="n">slippage</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="n">sign</span><span class="p">(</span><span class="n">delta</span><span class="p">)),</span> <span class="mi">6</span><span class="p">)</span>
            <span class="k">if</span> <span class="n">delta</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
                <span class="n">delta</span> <span class="o">=</span> <span class="n">affordable_buy</span><span class="p">(</span><span class="n">cash</span><span class="p">,</span> <span class="n">delta</span><span class="p">,</span> <span class="n">fill</span><span class="p">,</span> <span class="n">costs</span><span class="p">,</span> <span class="n">lot</span><span class="p">)</span>
            <span class="k">if</span> <span class="n">delta</span><span class="p">:</span>
                <span class="n">fee</span> <span class="o">=</span> <span class="n">trade_fee</span><span class="p">(</span><span class="n">delta</span><span class="p">,</span> <span class="n">fill</span><span class="p">,</span> <span class="n">costs</span><span class="p">)</span>
                <span class="n">cash</span> <span class="o">=</span> <span class="nb">round</span><span class="p">(</span><span class="n">cash</span> <span class="o">-</span> <span class="n">delta</span> <span class="o">*</span> <span class="n">fill</span> <span class="o">-</span> <span class="n">fee</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
                <span class="n">shares</span> <span class="o">+=</span> <span class="n">delta</span>
                <span class="n">trades</span><span class="p">.</span><span class="n">append</span><span class="p">({</span><span class="s">"date"</span><span class="p">:</span> <span class="n">row</span><span class="p">.</span><span class="n">date</span><span class="p">,</span>
                               <span class="s">"side"</span><span class="p">:</span> <span class="s">"buy"</span> <span class="k">if</span> <span class="n">delta</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="k">else</span> <span class="s">"sell"</span><span class="p">,</span>
                               <span class="s">"shares"</span><span class="p">:</span> <span class="nb">abs</span><span class="p">(</span><span class="n">delta</span><span class="p">),</span> <span class="s">"fill"</span><span class="p">:</span> <span class="n">fill</span><span class="p">,</span>
                               <span class="s">"fee"</span><span class="p">:</span> <span class="n">fee</span><span class="p">,</span> <span class="s">"cash_after"</span><span class="p">:</span> <span class="n">cash</span><span class="p">})</span>

        <span class="n">equity</span><span class="p">.</span><span class="n">append</span><span class="p">({</span><span class="s">"date"</span><span class="p">:</span> <span class="n">row</span><span class="p">.</span><span class="n">date</span><span class="p">,</span> <span class="s">"close"</span><span class="p">:</span> <span class="n">price</span><span class="p">,</span>
                       <span class="s">"shares"</span><span class="p">:</span> <span class="n">shares</span><span class="p">,</span> <span class="s">"cash"</span><span class="p">:</span> <span class="n">cash</span><span class="p">,</span>
                       <span class="s">"nav"</span><span class="p">:</span> <span class="n">cash</span> <span class="o">+</span> <span class="n">shares</span> <span class="o">*</span> <span class="n">price</span><span class="p">})</span>

    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">(</span><span class="n">equity</span><span class="p">),</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">(</span><span class="n">trades</span><span class="p">)</span>
</code></pre></div></div>

<p>这里没有为了向量化牺牲可读性。完整历史只有 3291 行，单次回测不到一秒；现阶段更重要的是让每一笔交易都可以解释。</p>

<h2 id="绩效层先把口径写清楚">绩效层：先把口径写清楚</h2>

<p>绩效层负责算术，解释留给研究环节：</p>

<p>仓库版本同样保留输入校验。指标本身只需要这段算术：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># src/backtest/metrics.py（核心逻辑）
</span><span class="k">def</span> <span class="nf">summary</span><span class="p">(</span><span class="n">equity</span><span class="p">,</span> <span class="n">trades</span><span class="p">,</span> <span class="n">freq</span><span class="o">=</span><span class="mi">252</span><span class="p">):</span>
    <span class="n">nav</span> <span class="o">=</span> <span class="n">equity</span><span class="p">[</span><span class="s">"nav"</span><span class="p">]</span>
    <span class="n">returns</span> <span class="o">=</span> <span class="n">nav</span><span class="p">.</span><span class="n">pct_change</span><span class="p">().</span><span class="n">dropna</span><span class="p">()</span>
    <span class="n">years</span> <span class="o">=</span> <span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">nav</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">freq</span>
    <span class="n">cagr</span> <span class="o">=</span> <span class="p">(</span><span class="n">nav</span><span class="p">.</span><span class="n">iloc</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">/</span> <span class="n">nav</span><span class="p">.</span><span class="n">iloc</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span> <span class="o">**</span> <span class="p">(</span><span class="mi">1</span> <span class="o">/</span> <span class="n">years</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span>
    <span class="n">drawdown</span> <span class="o">=</span> <span class="p">(</span><span class="n">nav</span> <span class="o">/</span> <span class="n">nav</span><span class="p">.</span><span class="n">cummax</span><span class="p">()</span> <span class="o">-</span> <span class="mi">1</span><span class="p">).</span><span class="nb">min</span><span class="p">()</span>
    <span class="n">sharpe</span> <span class="o">=</span> <span class="n">returns</span><span class="p">.</span><span class="n">mean</span><span class="p">()</span> <span class="o">/</span> <span class="n">returns</span><span class="p">.</span><span class="n">std</span><span class="p">()</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="n">sqrt</span><span class="p">(</span><span class="n">freq</span><span class="p">)</span>
    <span class="n">turnover</span> <span class="o">=</span> <span class="n">trades</span><span class="p">[</span><span class="s">"shares"</span><span class="p">].</span><span class="n">mul</span><span class="p">(</span><span class="n">trades</span><span class="p">[</span><span class="s">"fill"</span><span class="p">]).</span><span class="nb">sum</span><span class="p">()</span> <span class="o">/</span> <span class="n">nav</span><span class="p">.</span><span class="n">iloc</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>

    <span class="k">return</span> <span class="p">{</span>
        <span class="s">"年化"</span><span class="p">:</span> <span class="nb">round</span><span class="p">(</span><span class="n">cagr</span><span class="p">,</span> <span class="mi">4</span><span class="p">),</span>
        <span class="s">"最大回撤"</span><span class="p">:</span> <span class="nb">round</span><span class="p">(</span><span class="n">drawdown</span><span class="p">,</span> <span class="mi">4</span><span class="p">),</span>
        <span class="s">"夏普"</span><span class="p">:</span> <span class="nb">round</span><span class="p">(</span><span class="n">sharpe</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span>
        <span class="s">"累计换手"</span><span class="p">:</span> <span class="nb">round</span><span class="p">(</span><span class="n">turnover</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span>
        <span class="s">"交易笔数"</span><span class="p">:</span> <span class="nb">len</span><span class="p">(</span><span class="n">trades</span><span class="p">),</span>
        <span class="s">"总费用"</span><span class="p">:</span> <span class="nb">round</span><span class="p">(</span><span class="n">trades</span><span class="p">[</span><span class="s">"fee"</span><span class="p">].</span><span class="nb">sum</span><span class="p">(),</span> <span class="mi">2</span><span class="p">),</span>
    <span class="p">}</span>
</code></pre></div></div>

<p>夏普使用零无风险利率，年化按每年 252 个交易日计算。累计换手是所有成交额除以初始净值，是单边累计口径。年化区间使用 <code class="language-plaintext highlighter-rouge">len(nav) - 1</code> 个收益周期，不把第一天误算成一段收益。</p>

<h2 id="三个最容易骗人的地方">三个最容易骗人的地方</h2>

<p>未来函数是第一个。用当天收盘价计算信号又按当天收盘价成交、用后视才知道的成分股名单回测历史，都属于这一类。我的防线是双重的：信号函数只使用因果窗口，成交层再强制 T+1。</p>

<p>成本假设是第二个。我目前使用佣金万分之三、单笔最低 5 元和单边千一滑点；ETF 不计印花税。滑点没人给你保证，所以还要把佣金和滑点加倍再跑一遍。</p>

<p>成交可行性是第三个。当前代码已经处理现金上限和 100 份整手约束。涨跌停无法成交、停牌顺延暂未实现，因为这两个宽基 ETF 基线没有用到；进入 A 股个股阶段时，再把成交状态作为明确接口加入，不能提前假装已经处理。</p>

<h2 id="这次检查到哪一步">这次检查到哪一步</h2>

<p>这版先验证了两件事：</p>

<ul class="task-list">
  <li class="task-list-item"><input type="checkbox" class="task-list-item-checkbox" disabled="disabled" checked="checked" />把成本加倍，看看结果会变成什么样</li>
  <li class="task-list-item"><input type="checkbox" class="task-list-item-checkbox" disabled="disabled" checked="checked" />抽一笔交易，从信号到成交手算一遍</li>
</ul>

<p>另外三项暂时没做：</p>

<ul class="task-list">
  <li class="task-list-item"><input type="checkbox" class="task-list-item-checkbox" disabled="disabled" />划分样本内和样本外</li>
  <li class="task-list-item"><input type="checkbox" class="task-list-item-checkbox" disabled="disabled" />扰动均线参数，观察结果是否稳定</li>
  <li class="task-list-item"><input type="checkbox" class="task-list-item-checkbox" disabled="disabled" />分别查看上涨、下跌和震荡阶段的表现</li>
</ul>

<p>它们更适合留到正式研究轮动策略时再做。这一篇先确认回测器算得对，不急着证明某个策略有效。</p>

<h2 id="先跑两个不性感的基线">先跑两个不性感的基线</h2>

<p>回测器写完，先不跑轮动策略，而是跑两个「无聊」的基线：一次性买入并持有，以及双均线。</p>

<p>这里特意改掉“定投”的叫法。<code class="language-plaintext highlighter-rouge">buy_and_hold</code> 是初始资金一次性买入，此后持续持有；真正的定投还需要定义每期外部现金流、投入日期和收益率口径，不能混为一谈。</p>

<p>它们是两把尺子。买入并持有给出被动基准，双均线暴露趋势策略的滞后和换手成本。以后任何策略扣完成本还跑不过被动基准，就不值得继续增加复杂度。</p>

<p>正文里的运行脚本也只保留实验本身。路径处理、目录创建和封装函数仍在仓库版本中：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># scripts/run_baseline.py（核心逻辑）
</span><span class="n">df</span> <span class="o">=</span> <span class="n">load_daily</span><span class="p">(</span><span class="s">"510300"</span><span class="p">,</span> <span class="n">adjust</span><span class="o">=</span><span class="s">"hfq"</span><span class="p">)</span>

<span class="n">cases</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="s">"buy_and_hold"</span><span class="p">,</span> <span class="n">buy_and_hold</span><span class="p">(</span><span class="n">df</span><span class="p">),</span> <span class="n">Costs</span><span class="p">()),</span>
    <span class="p">(</span><span class="s">"sma_20_60"</span><span class="p">,</span> <span class="n">sma_cross</span><span class="p">(</span><span class="n">df</span><span class="p">),</span> <span class="n">Costs</span><span class="p">()),</span>
    <span class="p">(</span><span class="s">"sma_20_60_double_cost"</span><span class="p">,</span> <span class="n">sma_cross</span><span class="p">(</span><span class="n">df</span><span class="p">),</span>
     <span class="n">Costs</span><span class="p">(</span><span class="n">commission</span><span class="o">=</span><span class="mf">0.0006</span><span class="p">,</span> <span class="n">slippage</span><span class="o">=</span><span class="mf">0.002</span><span class="p">)),</span>
<span class="p">]</span>

<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">signal</span><span class="p">,</span> <span class="n">costs</span> <span class="ow">in</span> <span class="n">cases</span><span class="p">:</span>
    <span class="n">equity</span><span class="p">,</span> <span class="n">trades</span> <span class="o">=</span> <span class="n">run_backtest</span><span class="p">(</span><span class="n">df</span><span class="p">,</span> <span class="n">signal</span><span class="p">,</span> <span class="n">costs</span><span class="o">=</span><span class="n">costs</span><span class="p">)</span>
    <span class="k">print</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">summary</span><span class="p">(</span><span class="n">equity</span><span class="p">,</span> <span class="n">trades</span><span class="p">))</span>
    <span class="k">if</span> <span class="n">name</span> <span class="o">!=</span> <span class="s">"sma_20_60_double_cost"</span><span class="p">:</span>
        <span class="n">equity</span><span class="p">.</span><span class="n">to_csv</span><span class="p">(</span><span class="sa">f</span><span class="s">"data/</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">_equity.csv"</span><span class="p">,</span> <span class="n">index</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">trades</span><span class="p">.</span><span class="n">to_csv</span><span class="p">(</span><span class="sa">f</span><span class="s">"data/</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">_trades.csv"</span><span class="p">,</span> <span class="n">index</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
</code></pre></div></div>

<p>脚本从项目根目录直接运行：</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>.venv/bin/python scripts/run_baseline.py
</code></pre></div></div>

<p>每个基线输出一份净值 CSV 和一份交易 CSV：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">data/buy_and_hold_equity.csv</code></li>
  <li><code class="language-plaintext highlighter-rouge">data/buy_and_hold_trades.csv</code></li>
  <li><code class="language-plaintext highlighter-rouge">data/sma_20_60_equity.csv</code></li>
  <li><code class="language-plaintext highlighter-rouge">data/sma_20_60_trades.csv</code></li>
</ul>

<h2 id="510300-实际运行结果">510300 实际运行结果</h2>

<p>这次使用仓库 DuckDB 中的 510300 后复权日线，区间为 2013-01-04 至 2026-07-24，共 3291 个交易日。初始资金 100,000 元，每手 100 份。</p>

<ul>
  <li>买入并持有
    <ul>
      <li>年化：6.12%</li>
      <li>最大回撤：-44.37%</li>
      <li>夏普：0.39</li>
      <li>累计换手：1.00</li>
      <li>交易笔数：1</li>
      <li>总费用：29.99 元</li>
    </ul>
  </li>
  <li>SMA 20/60
    <ul>
      <li>年化：0.82%</li>
      <li>最大回撤：-47.42%</li>
      <li>夏普：0.13</li>
      <li>累计换手：73.32</li>
      <li>交易笔数：70</li>
      <li>总费用：2,199.54 元</li>
    </ul>
  </li>
  <li>SMA 20/60（佣金与滑点加倍）
    <ul>
      <li>年化：0.13%</li>
      <li>最大回撤：-50.01%</li>
      <li>夏普：0.08</li>
      <li>累计换手：69.96</li>
      <li>交易笔数：70</li>
      <li>总费用：4,197.74 元</li>
    </ul>
  </li>
</ul>

<p>结果并不漂亮，但这正是基线的价值。这个区间里，双均线扣除成本后明显跑输买入并持有；佣金和滑点加倍后，年化从 0.82% 进一步降到 0.13%，最大回撤扩大到 50.01%。这说明当前的 20/60 参数没有提供足够厚的收益缓冲，不能因为它“看起来像一个策略”就继续包装。</p>

<p>成本加倍后的累计换手略低，不是成交次数减少，而是更高成本持续侵蚀净值，在整手约束下后续可成交份数变少。</p>

<h3 id="抽查第一笔交易">抽查第一笔交易</h3>

<p>买入并持有的首日信号在下一交易日成交：</p>

<table>
  <thead>
    <tr>
      <th>字段</th>
      <th>数值</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>信号日</td>
      <td>2013-01-04</td>
    </tr>
    <tr>
      <td>成交日</td>
      <td>2013-01-07</td>
    </tr>
    <tr>
      <td>成交方向</td>
      <td>买入</td>
    </tr>
    <tr>
      <td>成交份数</td>
      <td>38,900</td>
    </tr>
    <tr>
      <td>模拟成交价</td>
      <td>2.569567 元</td>
    </tr>
    <tr>
      <td>佣金</td>
      <td>29.99 元</td>
    </tr>
    <tr>
      <td>成交后现金</td>
      <td>13.85 元</td>
    </tr>
  </tbody>
</table>

<p>手算结果为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>100000 - 38900 × 2.569567 - 29.99 = 13.8537
按分取整后为 13.85 元
</code></pre></div></div>

<p>完整结果还通过了这些机器检查：</p>

<ul>
  <li>7 个回归测试全部通过；</li>
  <li>两条净值序列都恰好有 3291 行；</li>
  <li>所有持仓数量都是 100 的整数倍；</li>
  <li>买入并持有、双均线的最低现金分别为 13.85 元和 10.99 元，没有负现金；</li>
  <li><code class="language-plaintext highlighter-rouge">nav = cash + shares × close</code> 的最大误差约为 <code class="language-plaintext highlighter-rouge">1e-11</code>，属于浮点表示误差；</li>
  <li>修改未来价格不会改变过去的双均线信号；</li>
  <li>T 日信号只会在 T+1 产生持仓变化。</li>
</ul>

<h2 id="这一阶段的完成标准">这一阶段的完成标准</h2>

<p>完成标准只有一条：对一个简单策略，输出可复现的回测报告和全部交易明细。换一台机器，在相同数据和依赖版本上重跑，数字一致。</p>

<p>这一步已经跑通。更重要的结论不是“双均线赚了多少”，而是这套回测器已经能主动暴露一个策略在成本、回撤和成交约束下的问题。下一篇再开始做月度动量轮动。</p>

<blockquote>
  <p>本系列不构成投资建议。回测收益不代表实盘收益，历史数据不保证未来表现。</p>
</blockquote>]]></content><author><name>王翊仰</name></author><category term="AI 量化学习笔记" /><summary type="html"><![CDATA[《AI 量化学习笔记》第 4 篇：回测最大的风险不是写不出来，而是写出一个会骗人的。不用现成框架，自己写一个五层结构（数据/信号/组合/成交/绩效）的简易回测器，显式处理未来函数、成本假设、现金约束和 T+1，并用 510300 完整历史跑通买入并持有、双均线与成本加倍基线。]]></summary></entry><entry><title type="html">一台 MacBook 就够了：我的量化研究环境搭建实录</title><link href="https://www.wangyiyang.cc/2026/07/27/macbook/" rel="alternate" type="text/html" title="一台 MacBook 就够了：我的量化研究环境搭建实录" /><published>2026-07-27T00:00:00+08:00</published><updated>2026-07-27T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/27/macbook</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/27/macbook/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-27-macbook/01.png" alt="" /></p>
<blockquote>
  <p>AI 量化学习笔记 · 第 3 篇</p>
</blockquote>

<p>上一篇还在等券商的书面答复，但研究环境没必要跟着停下来。数据、回测和因子研究都放在研究层，不绑定券商终端，现在就能做。
这篇记录我在 MacBook 上搭建研究环境的过程，并用 510300（沪深 300 ETF）跑通日线数据的拉取、入库、复权检查和画图。完整代码放在 <a href="https://github.com/wangyiyang/quant">https://github.com/wangyiyang/quant</a>。</p>
<h2 id="两条边界">两条边界</h2>
<p>前 3 个月不买新硬件。一只 ETF 十年的日线只有两千多行，即使扩到几百只 ETF，也只是几十万行。Apple Silicon 足够处理这个量级，先把现有机器用起来。
研究和执行也要分开。研究层只输出目标仓位；Windows、券商终端和下单接口留到第 4—6 个月处理。这样以后换券商或终端，研究代码不用跟着重写。</p>
<h2 id="先把目录搭好">先把目录搭好</h2>
<p>我不想从一个孤零零的 Jupyter Notebook 开始。Notebook 很适合试想法，但内容一多，很快就分不清哪个 cell 才是最终版本。所以第一天我就把目录、依赖和版本控制搭好。</p>
<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>quant/
├── data/          # DuckDB 文件与原始缓存（不进 Git）
├── src/
│   ├── fetch/     # 数据拉取：akshare / baostock
│   ├── db/        # 入库与查询
│   └── viz/       # 画图
├── notebooks/     # 探索性分析，结论必须回流到 src/
├── tests/
├── .env           # 密钥与配置（不进 Git）
└── README.md
</code></pre></div></div>
<p>初始化只有几条命令，一次性做完就不用再想：</p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nb">mkdir</span> <span class="nt">-p</span> quant/<span class="o">{</span>data,src/<span class="o">{</span>fetch,db,viz<span class="o">}</span>,notebooks,tests<span class="o">}</span>
<span class="nb">cd </span>quant
python3.11 <span class="nt">-m</span> venv .venv <span class="o">&amp;&amp;</span> <span class="nb">source</span> .venv/bin/activate
pip <span class="nb">install </span>akshare baostock duckdb pandas numpy plotly pytest python-dotenv
pip freeze <span class="o">&gt;</span> requirements.txt
<span class="nb">printf</span> <span class="s1">'data/\n.venv/\n.env\n__pycache__/\n'</span> <span class="o">&gt;</span> .gitignore
git init <span class="o">&amp;&amp;</span> git add <span class="nt">-A</span> <span class="o">&amp;&amp;</span> git commit <span class="nt">-m</span> <span class="s2">"chore: init quant research env"</span>
</code></pre></div></div>
<p>Notebook 只负责探索；需要复用的逻辑放进 <code class="language-plaintext highlighter-rouge">src/</code> 并补测试。数据文件和密钥不进 Git。</p>
<h2 id="软件栈">软件栈</h2>
<p>环境用 Python 3.11 和 venv，数据处理与画图选 pandas、numpy、plotly。日线数据量不大，先用熟悉的工具，不为暂时用不到的性能引入 polars。行情由 akshare 拉取，baostock 用来交叉核对。
数据落在 DuckDB。CSV 遇到复权因子更新时需要重写文件，历史数据一多就容易失控；SQLite 也能做，但 DuckDB 的列存和分析查询更适合这类工作负载，而且同样只需要一个本地文件。</p>
<h2 id="跑通-510300-日线">跑通 510300 日线</h2>
<p>流程是拉取、入库、检查复权，再画图。</p>
<h3 id="拉取">拉取</h3>
<p>akshare 的东财接口不需要 token。<code class="language-plaintext highlighter-rouge">adjust</code> 参数决定返回原始价还是复权价，这里两份都保存：</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># src/fetch/akshare_daily.py
</span><span class="kn">import</span> <span class="nn">akshare</span> <span class="k">as</span> <span class="n">ak</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>

<span class="n">COLS</span> <span class="o">=</span> <span class="p">{</span>
    <span class="s">"日期"</span><span class="p">:</span> <span class="s">"date"</span><span class="p">,</span> <span class="s">"开盘"</span><span class="p">:</span> <span class="s">"open"</span><span class="p">,</span> <span class="s">"最高"</span><span class="p">:</span> <span class="s">"high"</span><span class="p">,</span> <span class="s">"最低"</span><span class="p">:</span> <span class="s">"low"</span><span class="p">,</span>
    <span class="s">"收盘"</span><span class="p">:</span> <span class="s">"close"</span><span class="p">,</span> <span class="s">"成交量"</span><span class="p">:</span> <span class="s">"volume"</span><span class="p">,</span> <span class="s">"成交额"</span><span class="p">:</span> <span class="s">"amount"</span><span class="p">,</span>
<span class="p">}</span>

<span class="k">def</span> <span class="nf">fetch_etf_daily</span><span class="p">(</span><span class="n">symbol</span><span class="o">=</span><span class="s">"510300"</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="s">"20130101"</span><span class="p">,</span> <span class="n">end</span><span class="o">=</span><span class="s">"20260726"</span><span class="p">,</span> <span class="n">adjust</span><span class="o">=</span><span class="s">"hfq"</span><span class="p">):</span>
    <span class="s">"""adjust: "" 原始价 / "hfq" 后复权"""</span>
    <span class="n">df</span> <span class="o">=</span> <span class="n">ak</span><span class="p">.</span><span class="n">fund_etf_hist_em</span><span class="p">(</span>
        <span class="n">symbol</span><span class="o">=</span><span class="n">symbol</span><span class="p">,</span> <span class="n">period</span><span class="o">=</span><span class="s">"daily"</span><span class="p">,</span>
        <span class="n">start_date</span><span class="o">=</span><span class="n">start</span><span class="p">,</span> <span class="n">end_date</span><span class="o">=</span><span class="n">end</span><span class="p">,</span> <span class="n">adjust</span><span class="o">=</span><span class="n">adjust</span><span class="p">,</span>
    <span class="p">).</span><span class="n">rename</span><span class="p">(</span><span class="n">columns</span><span class="o">=</span><span class="n">COLS</span><span class="p">)</span>
    <span class="n">df</span><span class="p">[</span><span class="s">"date"</span><span class="p">]</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">to_datetime</span><span class="p">(</span><span class="n">df</span><span class="p">[</span><span class="s">"date"</span><span class="p">]).</span><span class="n">dt</span><span class="p">.</span><span class="n">date</span>
    <span class="n">df</span><span class="p">[</span><span class="s">"symbol"</span><span class="p">]</span> <span class="o">=</span> <span class="n">symbol</span>
    <span class="n">df</span><span class="p">[</span><span class="s">"adjust"</span><span class="p">]</span> <span class="o">=</span> <span class="n">adjust</span> <span class="ow">or</span> <span class="s">"raw"</span>
    <span class="k">return</span> <span class="p">(</span><span class="n">df</span><span class="p">[[</span><span class="s">"symbol"</span><span class="p">,</span> <span class="s">"date"</span><span class="p">,</span> <span class="s">"open"</span><span class="p">,</span> <span class="s">"high"</span><span class="p">,</span> <span class="s">"low"</span><span class="p">,</span> <span class="s">"close"</span><span class="p">,</span> <span class="s">"volume"</span><span class="p">,</span> <span class="s">"amount"</span><span class="p">,</span> <span class="s">"adjust"</span><span class="p">]]</span>
            <span class="p">.</span><span class="n">sort_values</span><span class="p">(</span><span class="s">"date"</span><span class="p">).</span><span class="n">reset_index</span><span class="p">(</span><span class="n">drop</span><span class="o">=</span><span class="bp">True</span><span class="p">))</span>
</code></pre></div></div>
<h3 id="入库">入库</h3>
<p>入库必须幂等：同一天重复拉取只能留一行，复权因子变化后也能整段回写。这里用主键定位旧记录，先删再插：</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># src/db/store.py
</span><span class="kn">import</span> <span class="nn">pathlib</span>
<span class="kn">import</span> <span class="nn">duckdb</span>

<span class="n">DB_PATH</span> <span class="o">=</span> <span class="n">pathlib</span><span class="p">.</span><span class="n">Path</span><span class="p">(</span><span class="s">"data/quant.duckdb"</span><span class="p">)</span>
<span class="n">SCHEMA</span> <span class="o">=</span> <span class="s">"""
create table if not exists etf_daily (
  symbol varchar, date date,
  open double, high double, low double, close double,
  volume bigint, amount double, adjust varchar,
  primary key (symbol, date, adjust)
);
"""</span>

<span class="k">def</span> <span class="nf">upsert_daily</span><span class="p">(</span><span class="n">df</span><span class="p">):</span>
    <span class="k">with</span> <span class="n">duckdb</span><span class="p">.</span><span class="n">connect</span><span class="p">(</span><span class="nb">str</span><span class="p">(</span><span class="n">DB_PATH</span><span class="p">))</span> <span class="k">as</span> <span class="n">con</span><span class="p">:</span>
        <span class="n">con</span><span class="p">.</span><span class="n">execute</span><span class="p">(</span><span class="n">SCHEMA</span><span class="p">)</span>
        <span class="n">con</span><span class="p">.</span><span class="n">register</span><span class="p">(</span><span class="s">"incoming"</span><span class="p">,</span> <span class="n">df</span><span class="p">)</span>
        <span class="n">con</span><span class="p">.</span><span class="n">execute</span><span class="p">(</span><span class="s">"""delete from etf_daily e
                       using incoming i
                       where e.symbol = i.symbol and e.date = i.date and e.adjust = i.adjust"""</span><span class="p">)</span>
        <span class="n">con</span><span class="p">.</span><span class="n">execute</span><span class="p">(</span><span class="s">"insert into etf_daily select * from incoming"</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">con</span><span class="p">.</span><span class="n">execute</span><span class="p">(</span><span class="s">"select count(*) from etf_daily"</span><span class="p">).</span><span class="n">fetchone</span><span class="p">()[</span><span class="mi">0</span><span class="p">]</span>

<span class="k">def</span> <span class="nf">load_daily</span><span class="p">(</span><span class="n">symbol</span><span class="o">=</span><span class="s">"510300"</span><span class="p">,</span> <span class="n">adjust</span><span class="o">=</span><span class="s">"hfq"</span><span class="p">):</span>
    <span class="k">with</span> <span class="n">duckdb</span><span class="p">.</span><span class="n">connect</span><span class="p">(</span><span class="nb">str</span><span class="p">(</span><span class="n">DB_PATH</span><span class="p">),</span> <span class="n">read_only</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="k">as</span> <span class="n">con</span><span class="p">:</span>
        <span class="k">return</span> <span class="n">con</span><span class="p">.</span><span class="n">execute</span><span class="p">(</span><span class="s">"""select date, open, high, low, close, volume
                             from etf_daily where symbol = ? and adjust = ?
                             order by date"""</span><span class="p">,</span> <span class="p">[</span><span class="n">symbol</span><span class="p">,</span> <span class="n">adjust</span><span class="p">]).</span><span class="n">df</span><span class="p">()</span>
</code></pre></div></div>
<h3 id="画图">画图</h3>
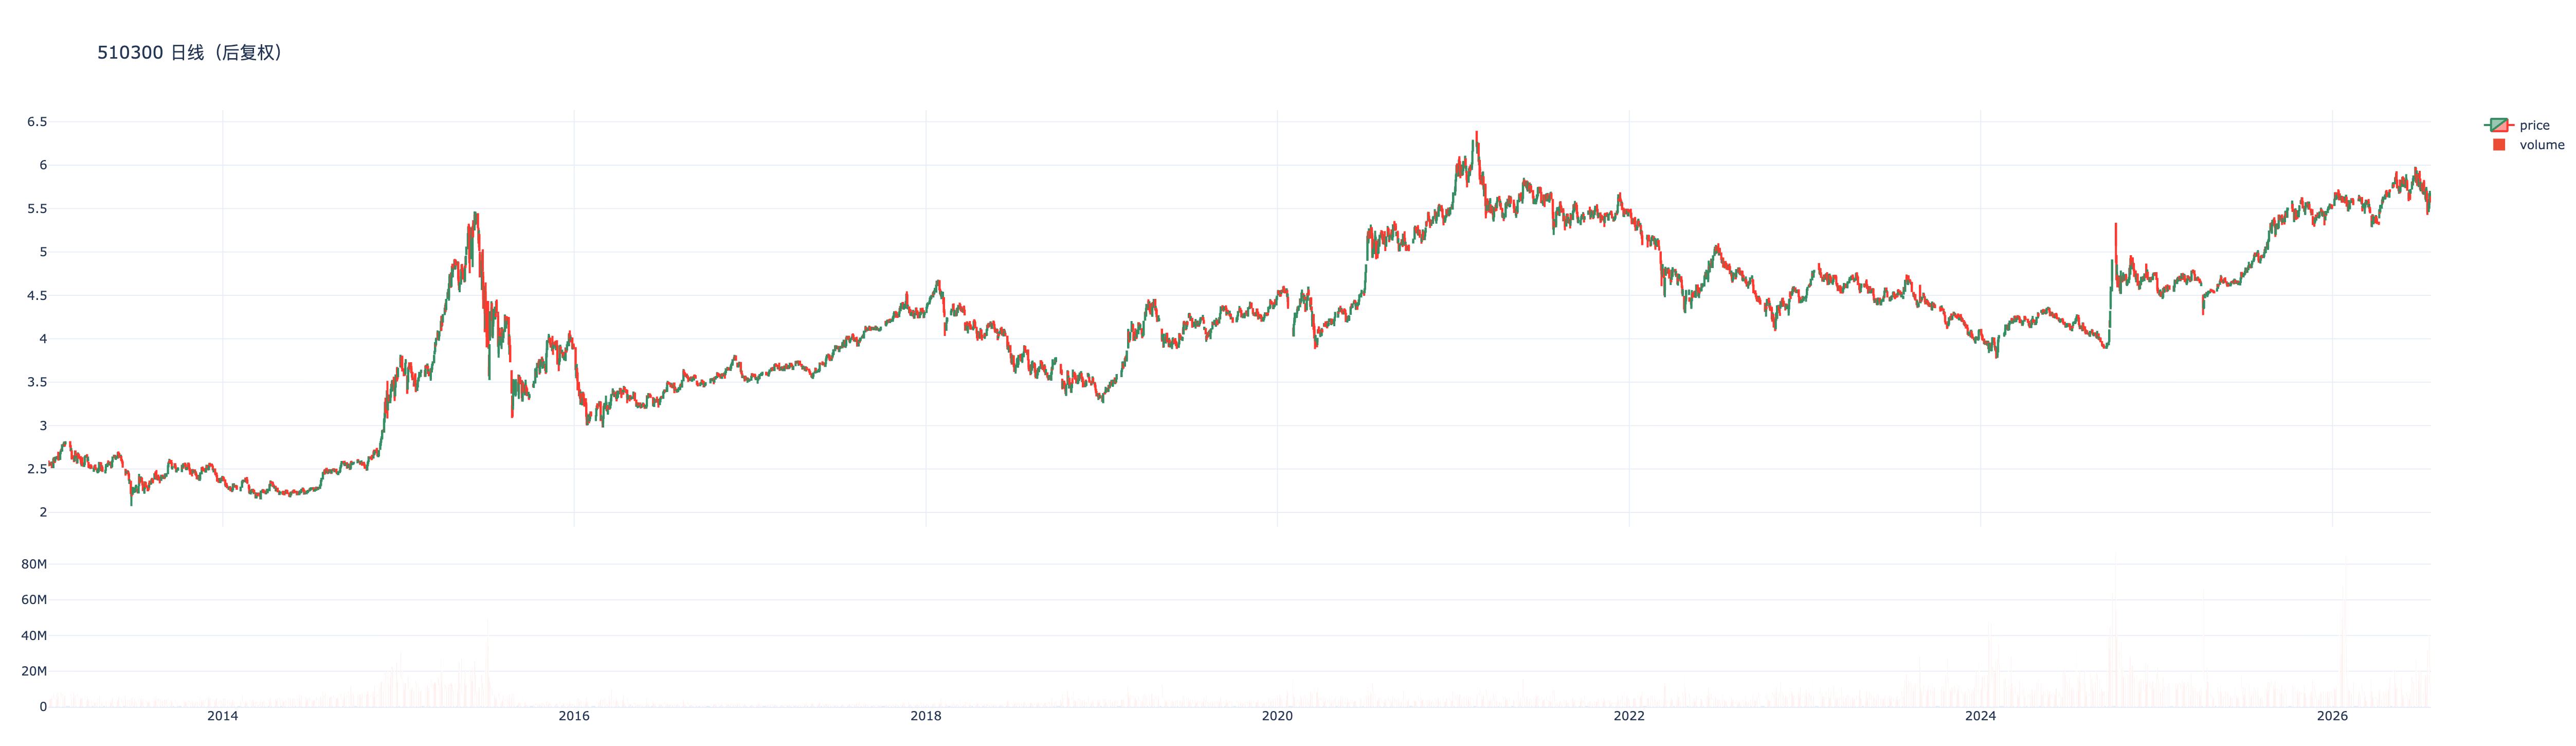
<p>plotly 负责 K 线和成交量副图，结果写成 HTML，直接用浏览器查看：</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># src/viz/candles.py
</span><span class="kn">import</span> <span class="nn">plotly.graph_objects</span> <span class="k">as</span> <span class="n">go</span>
<span class="kn">from</span> <span class="nn">plotly.subplots</span> <span class="kn">import</span> <span class="n">make_subplots</span>

<span class="k">def</span> <span class="nf">plot_candles</span><span class="p">(</span><span class="n">df</span><span class="p">,</span> <span class="n">symbol</span><span class="o">=</span><span class="s">"510300"</span><span class="p">,</span> <span class="n">out</span><span class="o">=</span><span class="s">"data/510300.html"</span><span class="p">):</span>
    <span class="n">fig</span> <span class="o">=</span> <span class="n">make_subplots</span><span class="p">(</span><span class="n">rows</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">cols</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">shared_xaxes</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                        <span class="n">row_heights</span><span class="o">=</span><span class="p">[</span><span class="mf">0.72</span><span class="p">,</span> <span class="mf">0.28</span><span class="p">],</span> <span class="n">vertical_spacing</span><span class="o">=</span><span class="mf">0.03</span><span class="p">)</span>
    <span class="n">fig</span><span class="p">.</span><span class="n">add_trace</span><span class="p">(</span><span class="n">go</span><span class="p">.</span><span class="n">Candlestick</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="n">df</span><span class="p">[</span><span class="s">"date"</span><span class="p">],</span> <span class="nb">open</span><span class="o">=</span><span class="n">df</span><span class="p">[</span><span class="s">"open"</span><span class="p">],</span> <span class="n">high</span><span class="o">=</span><span class="n">df</span><span class="p">[</span><span class="s">"high"</span><span class="p">],</span>
                                 <span class="n">low</span><span class="o">=</span><span class="n">df</span><span class="p">[</span><span class="s">"low"</span><span class="p">],</span> <span class="n">close</span><span class="o">=</span><span class="n">df</span><span class="p">[</span><span class="s">"close"</span><span class="p">],</span> <span class="n">name</span><span class="o">=</span><span class="s">"price"</span><span class="p">),</span> <span class="n">row</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">col</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">fig</span><span class="p">.</span><span class="n">add_trace</span><span class="p">(</span><span class="n">go</span><span class="p">.</span><span class="n">Bar</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="n">df</span><span class="p">[</span><span class="s">"date"</span><span class="p">],</span> <span class="n">y</span><span class="o">=</span><span class="n">df</span><span class="p">[</span><span class="s">"volume"</span><span class="p">],</span> <span class="n">name</span><span class="o">=</span><span class="s">"volume"</span><span class="p">),</span> <span class="n">row</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">col</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">fig</span><span class="p">.</span><span class="n">update_layout</span><span class="p">(</span><span class="n">title</span><span class="o">=</span><span class="sa">f</span><span class="s">"</span><span class="si">{</span><span class="n">symbol</span><span class="si">}</span><span class="s"> 日线（后复权）"</span><span class="p">,</span> <span class="n">xaxis_rangeslider_visible</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span>
                      <span class="n">height</span><span class="o">=</span><span class="mi">760</span><span class="p">,</span> <span class="n">template</span><span class="o">=</span><span class="s">"plotly_white"</span><span class="p">)</span>
    <span class="n">fig</span><span class="p">.</span><span class="n">write_html</span><span class="p">(</span><span class="n">out</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">out</span>
</code></pre></div></div>
<h3 id="串起来运行">串起来运行</h3>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># scripts/run_pipeline.py
</span><span class="kn">from</span> <span class="nn">src.fetch.akshare_daily</span> <span class="kn">import</span> <span class="n">fetch_etf_daily</span>
<span class="kn">from</span> <span class="nn">src.db.store</span> <span class="kn">import</span> <span class="n">upsert_daily</span><span class="p">,</span> <span class="n">load_daily</span>
<span class="kn">from</span> <span class="nn">src.viz.candles</span> <span class="kn">import</span> <span class="n">plot_candles</span>

<span class="k">for</span> <span class="n">adjust</span> <span class="ow">in</span> <span class="p">(</span><span class="s">""</span><span class="p">,</span> <span class="s">"hfq"</span><span class="p">):</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="n">upsert_daily</span><span class="p">(</span><span class="n">fetch_etf_daily</span><span class="p">(</span><span class="n">adjust</span><span class="o">=</span><span class="n">adjust</span><span class="p">))</span>
    <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"adjust=</span><span class="si">{</span><span class="n">adjust</span> <span class="ow">or</span> <span class="s">'raw'</span><span class="si">:</span><span class="o">&gt;</span><span class="mi">3</span><span class="si">}</span><span class="s"> -&gt; 库内累计 </span><span class="si">{</span><span class="n">rows</span><span class="si">}</span><span class="s"> 行"</span><span class="p">)</span>

<span class="n">df</span> <span class="o">=</span> <span class="n">load_daily</span><span class="p">(</span><span class="s">"510300"</span><span class="p">,</span> <span class="n">adjust</span><span class="o">=</span><span class="s">"hfq"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">df</span><span class="p">.</span><span class="n">tail</span><span class="p">(</span><span class="mi">3</span><span class="p">))</span>
<span class="k">print</span><span class="p">(</span><span class="s">"chart -&gt;"</span><span class="p">,</span> <span class="n">plot_candles</span><span class="p">(</span><span class="n">df</span><span class="p">))</span>
</code></pre></div></div>
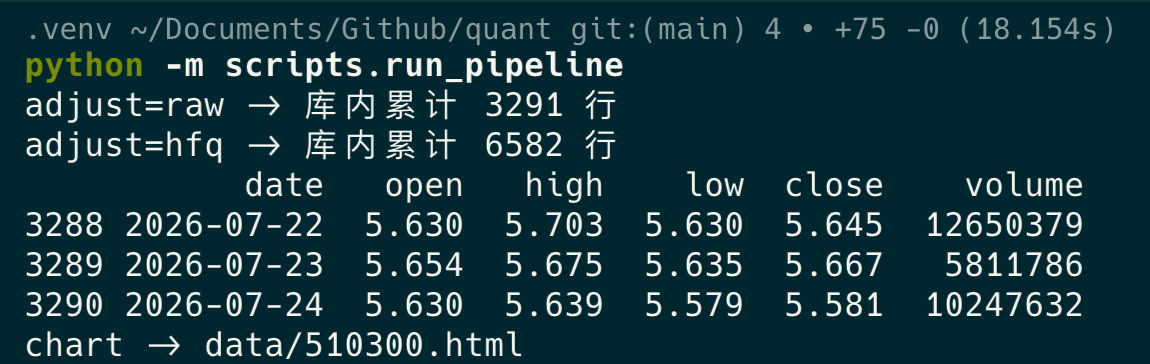
<p>执行方式有个细节：脚本里用了 <code class="language-plaintext highlighter-rouge">from src...</code> 的包导入，必须在项目根目录以模块方式运行；直接 <code class="language-plaintext highlighter-rouge">python scripts/run_pipeline.py</code> 会把 <code class="language-plaintext highlighter-rouge">scripts/</code> 当成搜索根，报 <code class="language-plaintext highlighter-rouge">ModuleNotFoundError: No module named 'src'</code>。</p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nb">cd </span>quant <span class="o">&amp;&amp;</span> <span class="nb">source</span> .venv/bin/activate
python <span class="nt">-m</span> scripts.run_pipeline
</code></pre></div></div>
<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-27-macbook/02.png" alt="" />
<img src="https://www.wangyiyang.cc/images/posts/2026-07-27-macbook/03.png" alt="" />
图能正常打开之后，我先检查了复权。
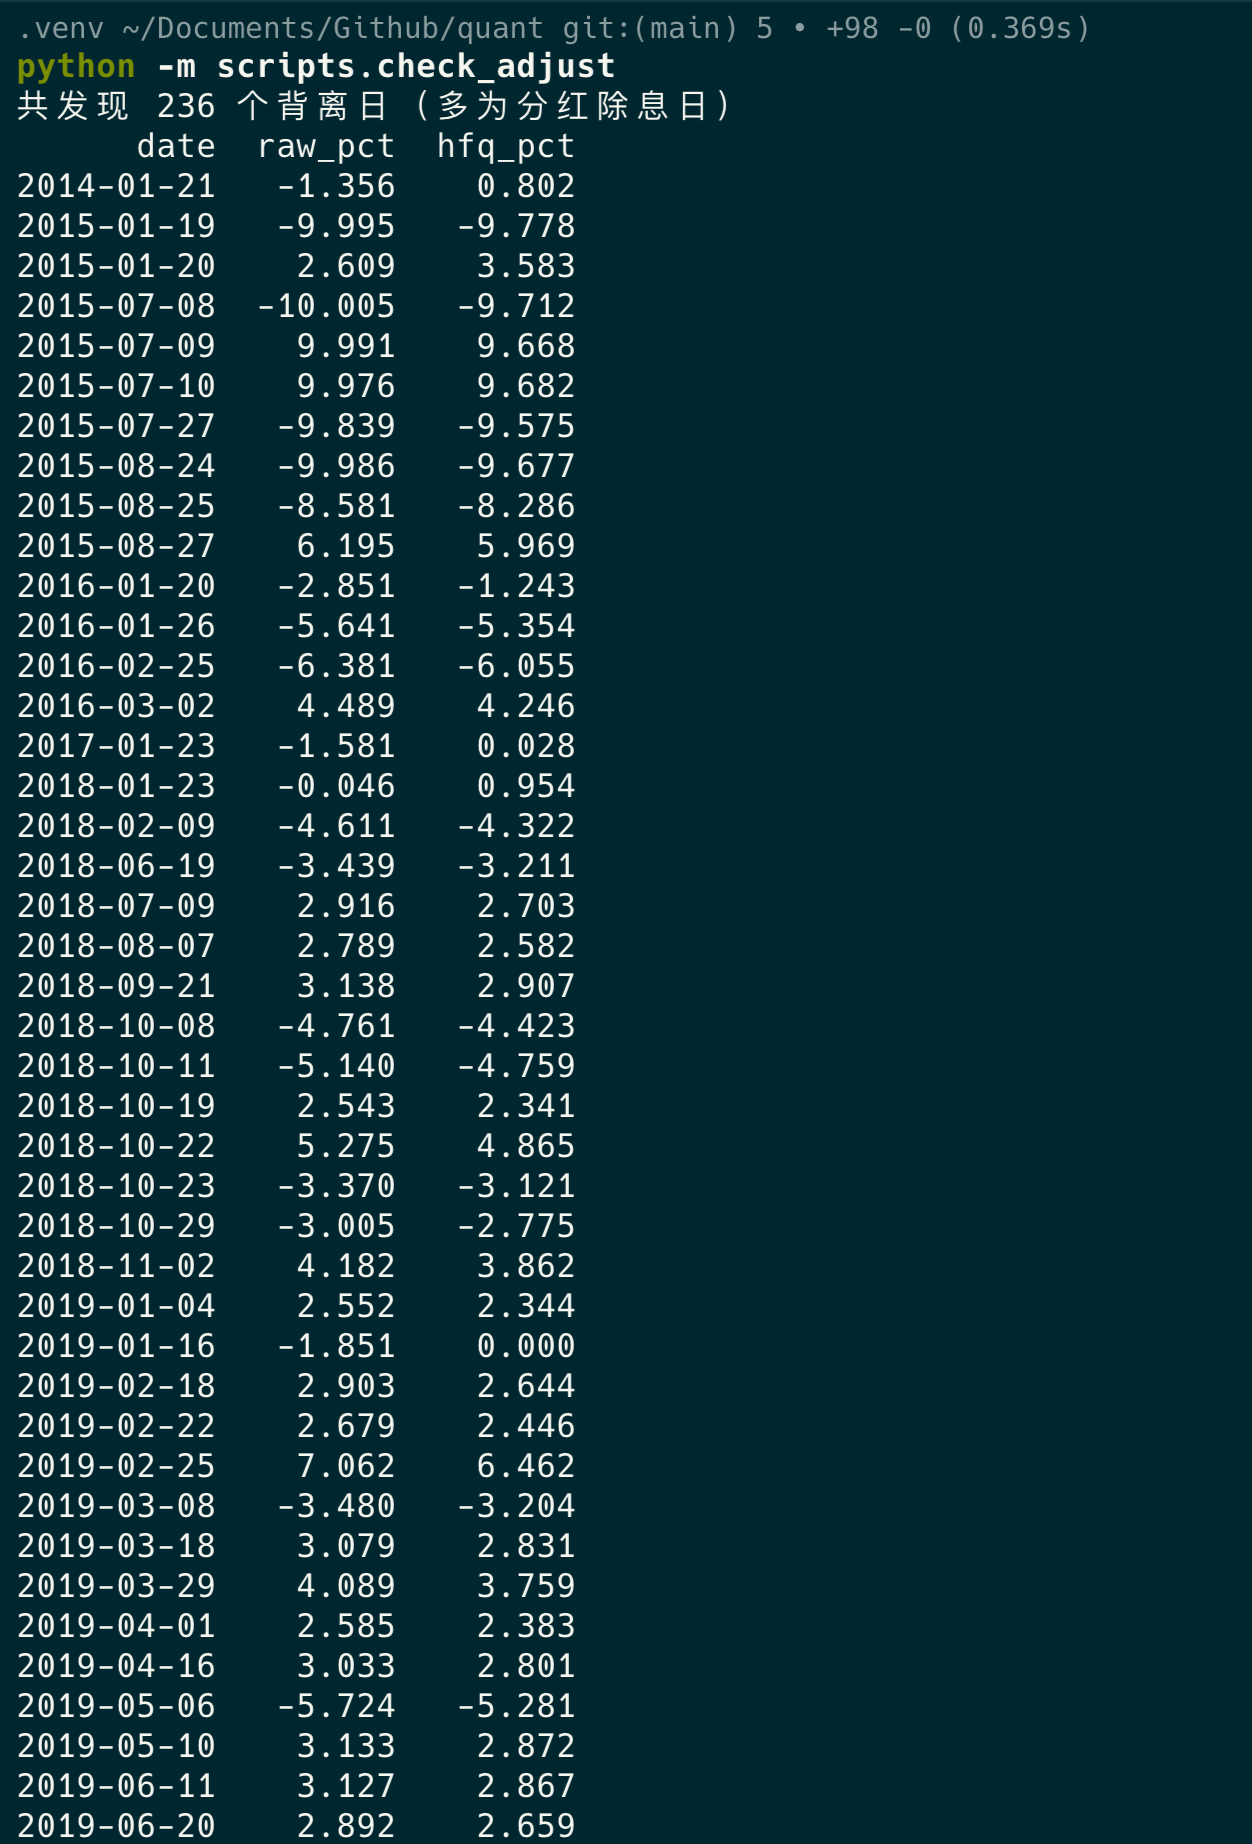
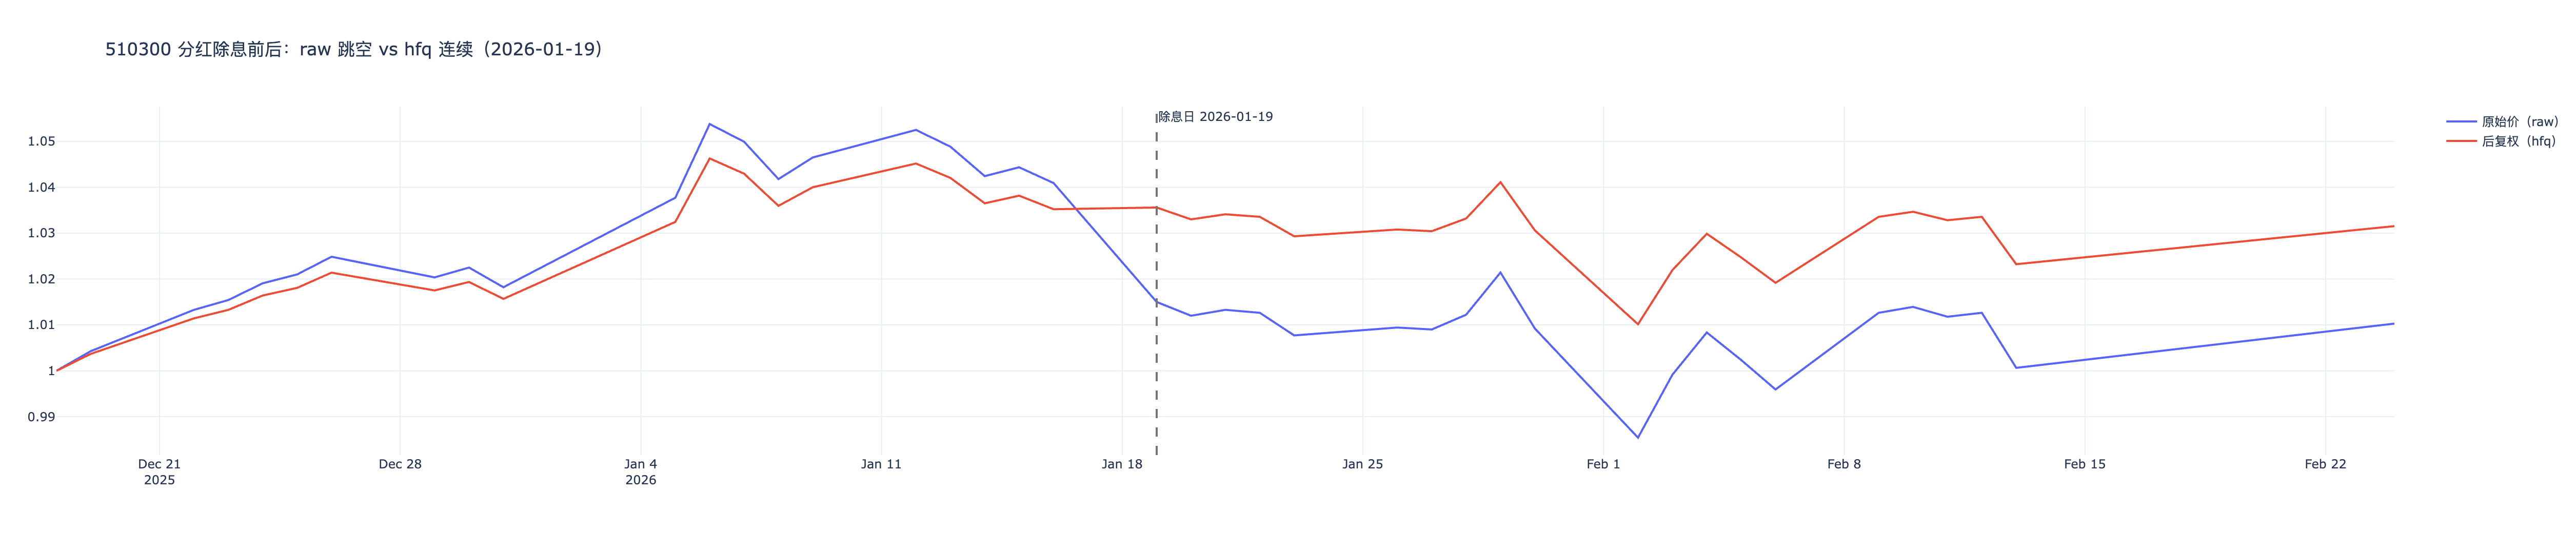
不复权的价格序列会在分红除息日向下跳空，直接拿它计算动量会产生假信号。我的处理是：后复权价格用于研究，原始价格保留下来核对成交。两份数据都在库里后，可以用 SQL 比较同一天的收益率；差值明显不为零的日期，通常就是分红除息日：</p>
<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">-- 找出原始价与后复权价日收益率背离的交易日</span>
<span class="k">with</span> <span class="n">r</span> <span class="k">as</span> <span class="p">(</span>
  <span class="k">select</span> <span class="nb">date</span><span class="p">,</span> <span class="n">adjust</span><span class="p">,</span>
         <span class="k">close</span> <span class="o">/</span> <span class="n">lag</span><span class="p">(</span><span class="k">close</span><span class="p">)</span> <span class="n">over</span> <span class="p">(</span><span class="k">partition</span> <span class="k">by</span> <span class="n">adjust</span> <span class="k">order</span> <span class="k">by</span> <span class="nb">date</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span> <span class="k">as</span> <span class="n">ret</span>
  <span class="k">from</span> <span class="n">etf_daily</span> <span class="k">where</span> <span class="n">symbol</span> <span class="o">=</span> <span class="s1">'510300'</span>
<span class="p">)</span>
<span class="k">select</span> <span class="n">a</span><span class="p">.</span><span class="nb">date</span><span class="p">,</span>
       <span class="n">round</span><span class="p">(</span><span class="n">a</span><span class="p">.</span><span class="n">ret</span> <span class="o">*</span> <span class="mi">100</span><span class="p">,</span> <span class="mi">3</span><span class="p">)</span> <span class="k">as</span> <span class="n">raw_pct</span><span class="p">,</span>
       <span class="n">round</span><span class="p">(</span><span class="n">b</span><span class="p">.</span><span class="n">ret</span> <span class="o">*</span> <span class="mi">100</span><span class="p">,</span> <span class="mi">3</span><span class="p">)</span> <span class="k">as</span> <span class="n">hfq_pct</span>
<span class="k">from</span> <span class="n">r</span> <span class="n">a</span> <span class="k">join</span> <span class="n">r</span> <span class="n">b</span> <span class="k">on</span> <span class="n">a</span><span class="p">.</span><span class="nb">date</span> <span class="o">=</span> <span class="n">b</span><span class="p">.</span><span class="nb">date</span>
<span class="k">where</span> <span class="n">a</span><span class="p">.</span><span class="n">adjust</span> <span class="o">=</span> <span class="s1">'raw'</span> <span class="k">and</span> <span class="n">b</span><span class="p">.</span><span class="n">adjust</span> <span class="o">=</span> <span class="s1">'hfq'</span>
  <span class="k">and</span> <span class="k">abs</span><span class="p">(</span><span class="n">a</span><span class="p">.</span><span class="n">ret</span> <span class="o">-</span> <span class="n">b</span><span class="p">.</span><span class="n">ret</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">.</span><span class="mi">002</span>
<span class="k">order</span> <span class="k">by</span> <span class="n">a</span><span class="p">.</span><span class="nb">date</span><span class="p">;</span>
</code></pre></div></div>
<p>这段 SQL 不放进 <code class="language-plaintext highlighter-rouge">run_pipeline.py</code>，而是保存为独立脚本 <code class="language-plaintext highlighter-rouge">scripts/check_adjust.py</code>。脚本以只读方式连接 <code class="language-plaintext highlighter-rouge">data/quant.duckdb</code>，执行上面的查询并打印背离日期；完整实现可以在 GitHub 仓库中查看。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-27-macbook/04.png" alt="" />
先运行 <code class="language-plaintext highlighter-rouge">run_pipeline</code>，把 raw 和 hfq 两份数据入库，再执行 <code class="language-plaintext highlighter-rouge">python -m scripts.check_adjust</code>。临时检查也可以安装 DuckDB CLI（<code class="language-plaintext highlighter-rouge">brew install duckdb</code>），然后用 <code class="language-plaintext highlighter-rouge">duckdb -readonly data/quant.duckdb</code> 打开。只读模式可以避免与正在写库的脚本争用连接。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-27-macbook/05.png" alt="" />
另一个容易混淆的地方是交易日。「过去 20 天」和「过去 20 个交易日」不是一回事，窗口计算必须按交易记录或交易所日历走，不能直接减 20 个自然日。</p>
<h2 id="用第二个数据源核对">用第二个数据源核对</h2>
<p>免费数据最麻烦的地方，是错误通常不会主动报出来。我用 baostock 再拉一份 510300 日线，与 akshare 的结果按日期对齐，检查收盘价偏差和单边缺失的日期。</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># src/fetch/crosscheck.py
</span><span class="kn">import</span> <span class="nn">baostock</span> <span class="k">as</span> <span class="n">bs</span>
<span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">from</span> <span class="nn">src.db.store</span> <span class="kn">import</span> <span class="n">load_daily</span>

<span class="k">def</span> <span class="nf">fetch_baostock</span><span class="p">(</span><span class="n">code</span><span class="o">=</span><span class="s">"sh.510300"</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="s">"2013-01-01"</span><span class="p">,</span> <span class="n">end</span><span class="o">=</span><span class="s">"2026-07-26"</span><span class="p">):</span>
    <span class="n">bs</span><span class="p">.</span><span class="n">login</span><span class="p">()</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="n">rs</span> <span class="o">=</span> <span class="n">bs</span><span class="p">.</span><span class="n">query_history_k_data_plus</span><span class="p">(</span>
            <span class="n">code</span><span class="p">,</span> <span class="s">"date,close,volume"</span><span class="p">,</span> <span class="n">start_date</span><span class="o">=</span><span class="n">start</span><span class="p">,</span> <span class="n">end_date</span><span class="o">=</span><span class="n">end</span><span class="p">,</span>
            <span class="n">frequency</span><span class="o">=</span><span class="s">"d"</span><span class="p">,</span> <span class="n">adjustflag</span><span class="o">=</span><span class="s">"3"</span><span class="p">,</span>  <span class="c1"># 3 = 不复权，与 raw 对齐
</span>        <span class="p">)</span>
        <span class="k">if</span> <span class="n">rs</span><span class="p">.</span><span class="n">error_code</span> <span class="o">!=</span> <span class="s">"0"</span><span class="p">:</span>
            <span class="k">raise</span> <span class="nb">RuntimeError</span><span class="p">(</span><span class="sa">f</span><span class="s">"baostock 查询失败：</span><span class="si">{</span><span class="n">rs</span><span class="p">.</span><span class="n">error_code</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">rs</span><span class="p">.</span><span class="n">error_msg</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
        <span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">while</span> <span class="n">rs</span><span class="p">.</span><span class="n">error_code</span> <span class="o">==</span> <span class="s">"0"</span> <span class="ow">and</span> <span class="n">rs</span><span class="p">.</span><span class="nb">next</span><span class="p">():</span>
            <span class="n">rows</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">rs</span><span class="p">.</span><span class="n">get_row_data</span><span class="p">())</span>
        <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"baostock 获取 </span><span class="si">{</span><span class="nb">len</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span><span class="si">}</span><span class="s"> 行，最后一天：</span><span class="si">{</span><span class="n">rows</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">][</span><span class="mi">0</span><span class="p">]</span> <span class="k">if</span> <span class="n">rows</span> <span class="k">else</span> <span class="s">'无数据'</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
    <span class="k">finally</span><span class="p">:</span>
        <span class="n">bs</span><span class="p">.</span><span class="n">logout</span><span class="p">()</span>

    <span class="n">df</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="s">"date"</span><span class="p">,</span> <span class="s">"close"</span><span class="p">,</span> <span class="s">"volume"</span><span class="p">])</span>
    <span class="n">df</span><span class="p">[</span><span class="s">"date"</span><span class="p">]</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">to_datetime</span><span class="p">(</span><span class="n">df</span><span class="p">[</span><span class="s">"date"</span><span class="p">])</span>
    <span class="k">return</span> <span class="n">df</span><span class="p">.</span><span class="n">astype</span><span class="p">({</span><span class="s">"close"</span><span class="p">:</span> <span class="nb">float</span><span class="p">,</span> <span class="s">"volume"</span><span class="p">:</span> <span class="nb">float</span><span class="p">})</span>

<span class="k">def</span> <span class="nf">crosscheck</span><span class="p">(</span><span class="n">tol</span><span class="o">=</span><span class="mf">0.005</span><span class="p">):</span>
    <span class="n">a</span> <span class="o">=</span> <span class="n">load_daily</span><span class="p">(</span><span class="s">"510300"</span><span class="p">,</span> <span class="n">adjust</span><span class="o">=</span><span class="s">"raw"</span><span class="p">).</span><span class="n">rename</span><span class="p">(</span>
        <span class="n">columns</span><span class="o">=</span><span class="p">{</span><span class="s">"close"</span><span class="p">:</span> <span class="s">"close_ak"</span><span class="p">,</span> <span class="s">"volume"</span><span class="p">:</span> <span class="s">"vol_ak"</span><span class="p">}</span>
    <span class="p">)</span>
    <span class="n">b</span> <span class="o">=</span> <span class="n">fetch_baostock</span><span class="p">().</span><span class="n">rename</span><span class="p">(</span>
        <span class="n">columns</span><span class="o">=</span><span class="p">{</span><span class="s">"close"</span><span class="p">:</span> <span class="s">"close_bs"</span><span class="p">,</span> <span class="s">"volume"</span><span class="p">:</span> <span class="s">"vol_bs"</span><span class="p">}</span>
    <span class="p">)</span>
    <span class="n">a</span><span class="p">[</span><span class="s">"date"</span><span class="p">]</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">to_datetime</span><span class="p">(</span><span class="n">a</span><span class="p">[</span><span class="s">"date"</span><span class="p">])</span>
    <span class="n">b</span><span class="p">[</span><span class="s">"date"</span><span class="p">]</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">to_datetime</span><span class="p">(</span><span class="n">b</span><span class="p">[</span><span class="s">"date"</span><span class="p">])</span>

    <span class="n">m</span> <span class="o">=</span> <span class="n">a</span><span class="p">.</span><span class="n">merge</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">on</span><span class="o">=</span><span class="s">"date"</span><span class="p">,</span> <span class="n">how</span><span class="o">=</span><span class="s">"outer"</span><span class="p">,</span> <span class="n">indicator</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">only</span> <span class="o">=</span> <span class="n">m</span><span class="p">[</span><span class="n">m</span><span class="p">[</span><span class="s">"_merge"</span><span class="p">]</span> <span class="o">!=</span> <span class="s">"both"</span><span class="p">][[</span><span class="s">"date"</span><span class="p">,</span> <span class="s">"_merge"</span><span class="p">]]</span>
    <span class="n">both</span> <span class="o">=</span> <span class="n">m</span><span class="p">[</span><span class="n">m</span><span class="p">[</span><span class="s">"_merge"</span><span class="p">]</span> <span class="o">==</span> <span class="s">"both"</span><span class="p">].</span><span class="n">copy</span><span class="p">()</span>
    <span class="n">both</span><span class="p">[</span><span class="s">"close_diff"</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span>
        <span class="p">(</span><span class="n">both</span><span class="p">[</span><span class="s">"close_ak"</span><span class="p">]</span> <span class="o">-</span> <span class="n">both</span><span class="p">[</span><span class="s">"close_bs"</span><span class="p">]).</span><span class="nb">abs</span><span class="p">()</span> <span class="o">/</span> <span class="n">both</span><span class="p">[</span><span class="s">"close_bs"</span><span class="p">]</span>
    <span class="p">)</span>
    <span class="n">bad</span> <span class="o">=</span> <span class="n">both</span><span class="p">[</span><span class="n">both</span><span class="p">[</span><span class="s">"close_diff"</span><span class="p">]</span> <span class="o">&gt;</span> <span class="n">tol</span><span class="p">][</span>
        <span class="p">[</span><span class="s">"date"</span><span class="p">,</span> <span class="s">"close_ak"</span><span class="p">,</span> <span class="s">"close_bs"</span><span class="p">,</span> <span class="s">"close_diff"</span><span class="p">]</span>
    <span class="p">]</span>
    <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"共同交易日 </span><span class="si">{</span><span class="nb">len</span><span class="p">(</span><span class="n">both</span><span class="p">)</span><span class="si">}</span><span class="s">，收盘价一致率 </span><span class="si">{</span><span class="mi">1</span> <span class="o">-</span> <span class="nb">len</span><span class="p">(</span><span class="n">bad</span><span class="p">)</span> <span class="o">/</span> <span class="nb">len</span><span class="p">(</span><span class="n">both</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="o">%</span><span class="si">}</span><span class="s">"</span><span class="p">)</span>
    <span class="k">print</span><span class="p">(</span><span class="sa">f</span><span class="s">"仅单边存在的日期 </span><span class="si">{</span><span class="nb">len</span><span class="p">(</span><span class="n">only</span><span class="p">)</span><span class="si">}</span><span class="s"> 天"</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">bad</span><span class="p">.</span><span class="n">sort_values</span><span class="p">(</span><span class="s">"date"</span><span class="p">),</span> <span class="n">only</span>
</code></pre></div></div>
<p>注意 <code class="language-plaintext highlighter-rouge">adjustflag="3"</code> 是不复权，必须和库里的 <code class="language-plaintext highlighter-rouge">raw</code> 那份比，拿复权价去对不复权价只会得到一堆假差异。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-27-macbook/06.png" alt="" />
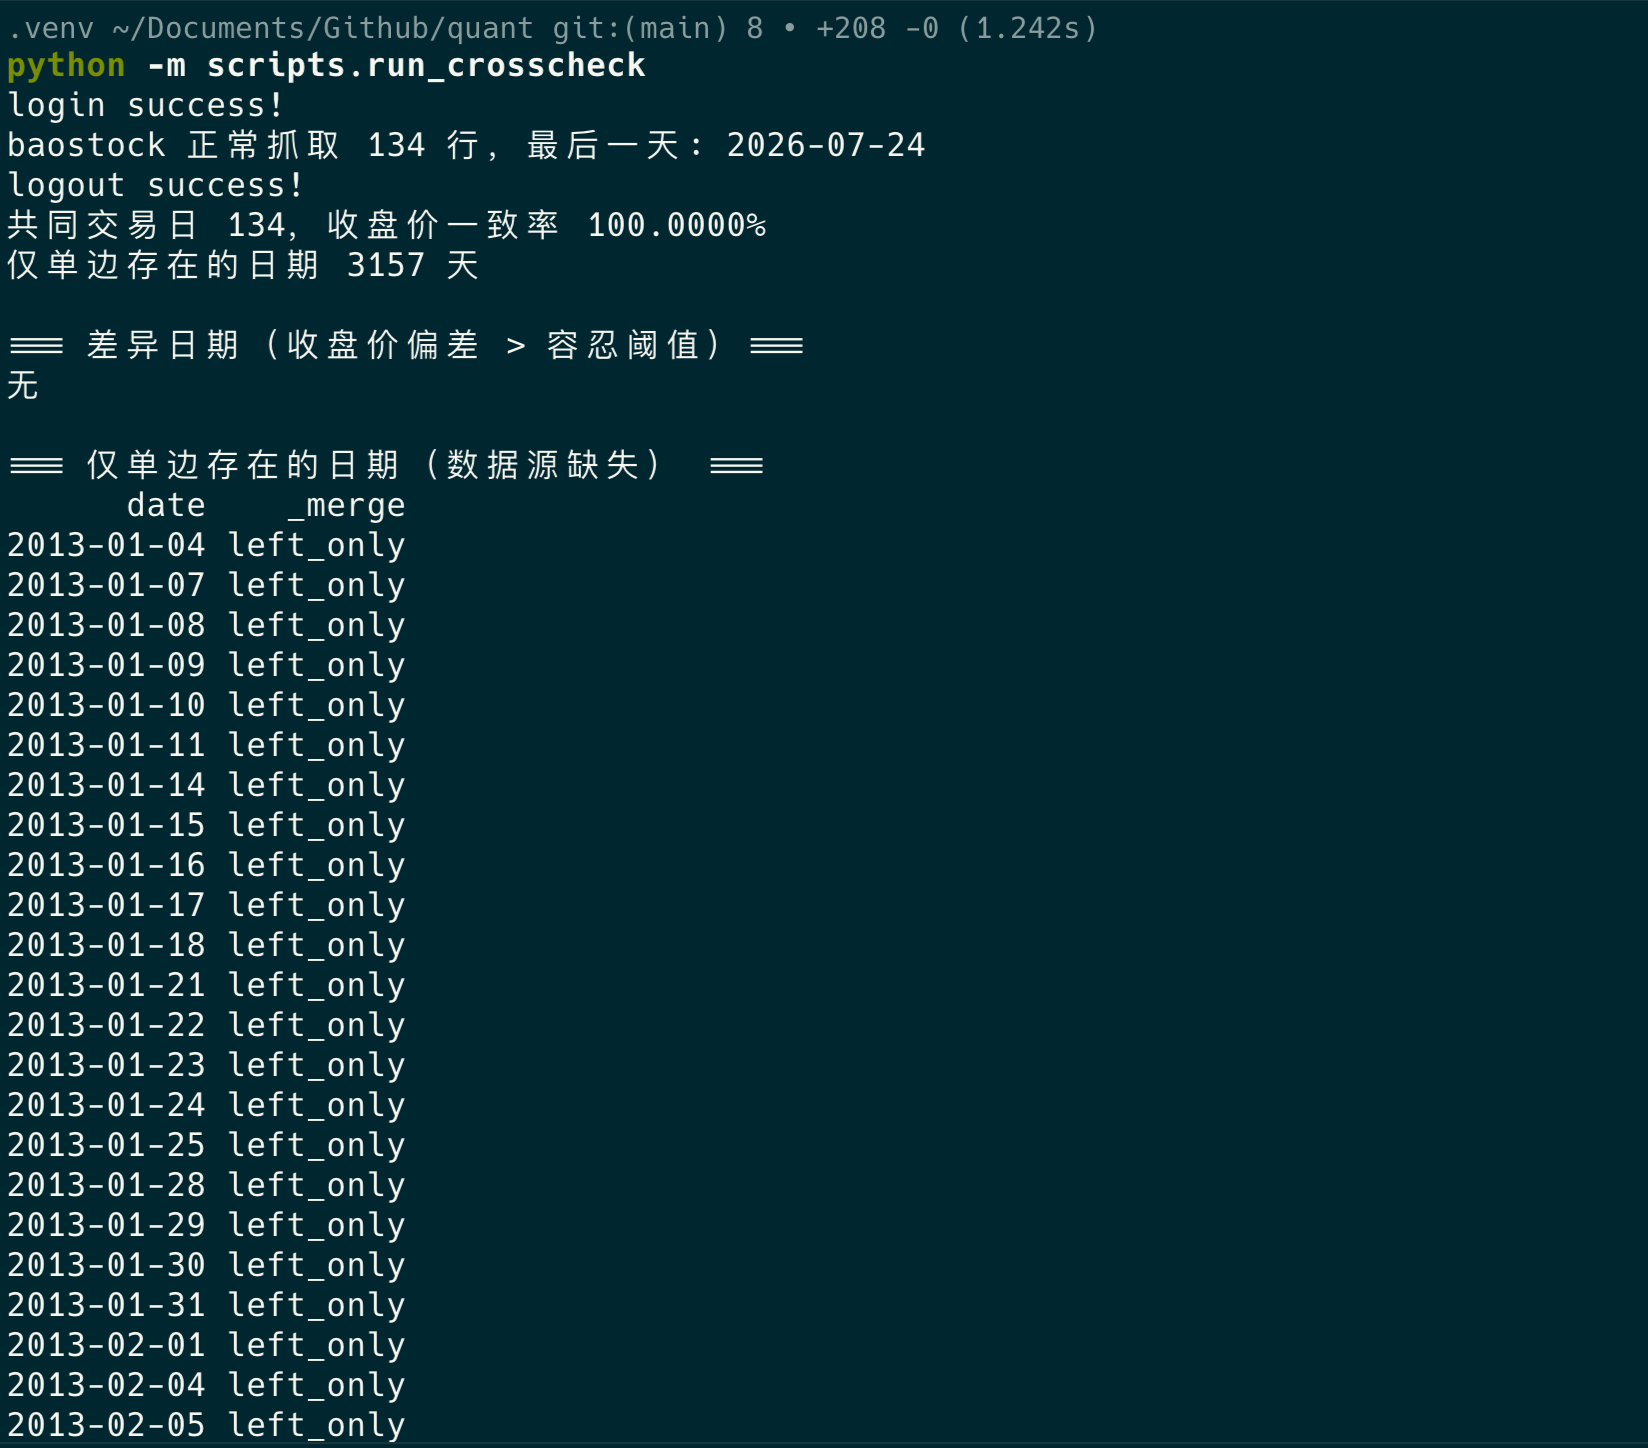
结果有两个数字值得记下来。两边共有 134 个交易日重叠，收盘价一致率为 100%，没有发现超过阈值的差异。与此同时，3157 个日期全部是 <code class="language-plaintext highlighter-rouge">left_only</code>，也就是 akshare 有数据、baostock 没有。baostock 这次只返回了 134 行，最后一天是 2026-07-24。
抓取过程没有报错，因此这里能确认的是：baostock 对本次 510300 查询只返回了较短的一段历史。重叠区间可以完成双源核对，更早的数据仍然只有 akshare 一个来源。后面做长期回测时，我会把这段数据边界写进结果说明，不把「部分区间验证通过」说成「全部历史都可靠」。
研究环境先停在这里。下一步开始写回测器，先保证每一笔交易都能复现。</p>
<blockquote>
  <p>本系列不构成投资建议。终端权限、资金门槛及程序化交易要求以券商的最新书面答复为准。</p>
</blockquote>]]></content><author><name>王翊仰</name></author><category term="AI 量化学习笔记" /><summary type="html"><![CDATA[一台 MacBook 就够了：我的量化研究环境搭建实录]]></summary></entry><entry><title type="html">很多人还是分不清 LangChain 和 LangGraph</title><link href="https://www.wangyiyang.cc/2026/07/25/langchain-langgraph/" rel="alternate" type="text/html" title="很多人还是分不清 LangChain 和 LangGraph" /><published>2026-07-25T00:00:00+08:00</published><updated>2026-07-25T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/25/langchain-langgraph</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/25/langchain-langgraph/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-25-langchain-langgraph/01.png" alt="很多人还是分不清 LangChain 和 LangGraph" />
前几天又看到有人问：「都 2026 年了，入门该学 LangChain 还是 LangGraph？听说前者已经过时了。」
这个问题我从 2024 年看到现在。
也不能全怪提问的人。官方的说法确实变过。2024 年 1 月 LangGraph 发布时，博客里的原话是「LangGraph is built on top of LangChain」；到 2025 年 10 月两个项目同时发布 1.0，定位成了「LangChain agents are built on LangGraph」。名字没变，上下层关系却在一年半里掉了个头。
我想把这段历史理顺，再给出一套现在能直接用的选型方法。</p>
<h2 id="一10-之前边界为什么这么模糊">一、1.0 之前，边界为什么这么模糊</h2>
<p>2022 年 10 月，LangChain 刚出现时，解决的是一个很具体的问题：不用每个人都重写模型调用和字符串拼接。<code class="language-plaintext highlighter-rouge">LLMChain</code>、<code class="language-plaintext highlighter-rouge">SequentialChain</code> 把 prompt、模型和解析器接成固定流水线，开箱就能跑。
2023 年，预制链逐渐显得太僵，官方推出 LangChain Expression Language（LCEL）。开发者可以用 <code class="language-plaintext highlighter-rouge">|</code> 把组件接成 <code class="language-plaintext highlighter-rouge">RunnableSequence</code>，也能做流式和批量处理。不过它仍然擅长线性或 DAG 控制流：数据从左往右走，很少回头。跨调用状态也不是原生能力，<code class="language-plaintext highlighter-rouge">RunnableWithMessageHistory</code> 更像后来补上的一块。
Agent 把问题暴露了出来。它不是单向流水线，而是一个循环：模型选择动作，工具执行，模型观察结果，再决定下一步。当时的 <code class="language-plaintext highlighter-rouge">AgentExecutor</code> 把循环包在黑盒里。想替换其中一步，或者增加持久化、人工介入和回退重试，都不轻松。线性管道很难承接这种需求。
2024 年 1 月，LangGraph 随 LangChain v0.1 发布，目标就是处理带状态的循环图。<code class="language-plaintext highlighter-rouge">StateGraph</code> 用节点和边描述应用，<code class="language-plaintext highlighter-rouge">add_conditional_edges</code> 允许流程往回跳。当时它确实是 LangChain 上层的扩展库：<code class="language-plaintext highlighter-rouge">langgraph</code> 依赖 <code class="language-plaintext highlighter-rouge">langchain-core</code>，工具使用 <code class="language-plaintext highlighter-rouge">BaseTool</code>，消息使用 <code class="language-plaintext highlighter-rouge">BaseMessage</code>，模型也走 LangChain 的聊天模型接口。LangChain 提供组件，LangGraph 增加执行引擎。
真正让人困惑的是 2024 年 5 月。LangChain 0.2 将 <code class="language-plaintext highlighter-rouge">initialize_agent</code>、<code class="language-plaintext highlighter-rouge">AgentExecutor</code> 标为 deprecated，并建议 Agent 用户转向 LangGraph。「LangGraph 是 LangChain 的升级版」也从那时流传开来。这个误解很容易理解：旧入口刚被弃用，官方紧接着让大家换另一个库。
接下来的几个月，LangGraph v0.1、LangGraph Cloud 和 LangGraph Studio 陆续发布。两套文档频繁互相引用。我写《LangChain 大模型应用开发·入门总览》时，也专门用了一段解释它们的关系。</p>
<h3 id="10-之前agent-代码换了三代">1.0 之前，Agent 代码换了三代</h3>
<p>时间线有点抽象，代码更直观。同样是让模型调用工具，1.0 之前先后出现过三种主流写法。
第一代是 <code class="language-plaintext highlighter-rouge">initialize_agent</code> + <code class="language-plaintext highlighter-rouge">AgentType</code>。模型在 prompt 中输出 <code class="language-plaintext highlighter-rouge">Action: ...</code>，框架再解析字符串：</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">langchain.agents</span> <span class="kn">import</span> <span class="n">initialize_agent</span><span class="p">,</span> <span class="n">AgentType</span>

<span class="n">agent</span> <span class="o">=</span> <span class="n">initialize_agent</span><span class="p">(</span>
    <span class="n">tools</span><span class="p">,</span>
    <span class="n">llm</span><span class="p">,</span>
    <span class="n">agent</span><span class="o">=</span><span class="n">AgentType</span><span class="p">.</span><span class="n">ZERO_SHOT_REACT_DESCRIPTION</span><span class="p">,</span>
<span class="p">)</span>
<span class="n">agent</span><span class="p">.</span><span class="n">run</span><span class="p">(</span><span class="s">"when was langchain made"</span><span class="p">)</span>
</code></pre></div></div>
<p>循环藏在 <code class="language-plaintext highlighter-rouge">agent.run()</code> 里面，开发者几乎碰不到。
第二代是 <code class="language-plaintext highlighter-rouge">create_tool_calling_agent</code> + <code class="language-plaintext highlighter-rouge">AgentExecutor</code>。模型原生支持 tool calling 后，调用变得更结构化，但 prompt 需要自己搭，<code class="language-plaintext highlighter-rouge">agent_scratchpad</code> 也是固定配置：</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">langchain.agents</span> <span class="kn">import</span> <span class="n">AgentExecutor</span><span class="p">,</span> <span class="n">create_tool_calling_agent</span>

<span class="n">prompt</span> <span class="o">=</span> <span class="n">ChatPromptTemplate</span><span class="p">.</span><span class="n">from_messages</span><span class="p">([</span>
    <span class="p">(</span><span class="s">"system"</span><span class="p">,</span> <span class="s">"You are a helpful assistant"</span><span class="p">),</span>
    <span class="p">(</span><span class="s">"human"</span><span class="p">,</span> <span class="s">"{input}"</span><span class="p">),</span>
    <span class="p">(</span><span class="s">"placeholder"</span><span class="p">,</span> <span class="s">"{agent_scratchpad}"</span><span class="p">),</span>
<span class="p">])</span>
<span class="n">agent</span> <span class="o">=</span> <span class="n">create_tool_calling_agent</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">tools</span><span class="p">,</span> <span class="n">prompt</span><span class="p">)</span>
<span class="n">executor</span> <span class="o">=</span> <span class="n">AgentExecutor</span><span class="p">(</span><span class="n">agent</span><span class="o">=</span><span class="n">agent</span><span class="p">,</span> <span class="n">tools</span><span class="o">=</span><span class="n">tools</span><span class="p">)</span>
<span class="n">executor</span><span class="p">.</span><span class="n">invoke</span><span class="p">({</span><span class="s">"input"</span><span class="p">:</span> <span class="s">"what is magic_function(3)?"</span><span class="p">})</span>
</code></pre></div></div>
<p>它比第一代可靠，但循环仍由 <code class="language-plaintext highlighter-rouge">AgentExecutor</code> 管着，局部改造依然麻烦。
第三代由 LangGraph 接管。简单场景可以使用 <code class="language-plaintext highlighter-rouge">langgraph.prebuilt.create_react_agent(model, tools)</code>，复杂场景则自己写状态图：</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">langgraph.graph</span> <span class="kn">import</span> <span class="n">StateGraph</span><span class="p">,</span> <span class="n">END</span>

<span class="n">workflow</span> <span class="o">=</span> <span class="n">StateGraph</span><span class="p">(</span><span class="n">AgentState</span><span class="p">)</span>
<span class="n">workflow</span><span class="p">.</span><span class="n">add_node</span><span class="p">(</span><span class="s">"agent"</span><span class="p">,</span> <span class="n">agent_node</span><span class="p">)</span>   <span class="c1"># 模型决策
</span><span class="n">workflow</span><span class="p">.</span><span class="n">add_node</span><span class="p">(</span><span class="s">"tools"</span><span class="p">,</span> <span class="n">tools_node</span><span class="p">)</span>   <span class="c1"># 执行工具
</span><span class="n">workflow</span><span class="p">.</span><span class="n">set_entry_point</span><span class="p">(</span><span class="s">"agent"</span><span class="p">)</span>
<span class="n">workflow</span><span class="p">.</span><span class="n">add_conditional_edges</span><span class="p">(</span><span class="s">"agent"</span><span class="p">,</span> <span class="n">should_continue</span><span class="p">,</span> <span class="p">{</span><span class="s">"tools"</span><span class="p">:</span> <span class="s">"tools"</span><span class="p">,</span> <span class="n">END</span><span class="p">:</span> <span class="n">END</span><span class="p">})</span>
<span class="n">workflow</span><span class="p">.</span><span class="n">add_edge</span><span class="p">(</span><span class="s">"tools"</span><span class="p">,</span> <span class="s">"agent"</span><span class="p">)</span>      <span class="c1"># 回到模型节点，形成循环
</span>
<span class="n">app</span> <span class="o">=</span> <span class="n">workflow</span><span class="p">.</span><span class="nb">compile</span><span class="p">()</span>
</code></pre></div></div>
<p>变化就在这几行代码里：原本藏在执行器里的循环，被拆成了可以查看和修改的图。1.0 的 <code class="language-plaintext highlighter-rouge">create_agent</code> 又把这张图封装起来，但保留了中间件入口，底层仍使用 LangGraph 运行时。</p>
<h2 id="二10-之后分层终于稳定">二、1.0 之后，分层终于稳定</h2>
<p>2025 年 10 月，<code class="language-plaintext highlighter-rouge">langchain</code> 和 <code class="language-plaintext highlighter-rouge">langgraph</code> 同时发布 1.0。此前模糊的边界基本定了下来。
LangGraph 1.0 成为底层运行时。图原语和执行模型保持稳定，durable execution、checkpointer 持久化、human-in-the-loop 仍是一等能力。它不再只是 LangChain 上面的扩展，而是整个 Agent 栈的执行底座。
LangChain 1.0 则收缩了包的表面积。旧链和 <code class="language-plaintext highlighter-rouge">AgentExecutor</code> 被移入 <code class="language-plaintext highlighter-rouge">langchain-classic</code>，新的核心入口是：</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">langchain.agents</span> <span class="kn">import</span> <span class="n">create_agent</span>

<span class="n">agent</span> <span class="o">=</span> <span class="n">create_agent</span><span class="p">(</span>
    <span class="n">model</span><span class="o">=</span><span class="s">"claude-sonnet-4-6"</span><span class="p">,</span>
    <span class="n">tools</span><span class="o">=</span><span class="p">[</span><span class="n">search_web</span><span class="p">,</span> <span class="n">analyze_data</span><span class="p">],</span>
    <span class="n">system_prompt</span><span class="o">=</span><span class="s">"You are a research assistant."</span><span class="p">,</span>
<span class="p">)</span>
</code></pre></div></div>
<p><code class="language-plaintext highlighter-rouge">create_agent</code> 取代了 <code class="language-plaintext highlighter-rouge">langgraph.prebuilt.create_react_agent</code>，内部生成 LangGraph 的 <code class="language-plaintext highlighter-rouge">CompiledStateGraph</code>。所以，用 LangChain 写出的 Agent 实际运行在 LangGraph 上，streaming、持久化和 HITL 中断都来自这层运行时。
需要定制时，也不必再改执行器黑盒。<code class="language-plaintext highlighter-rouge">before_model</code>、<code class="language-plaintext highlighter-rouge">wrap_model_call</code>、<code class="language-plaintext highlighter-rouge">wrap_tool_call</code>、<code class="language-plaintext highlighter-rouge">after_agent</code> 等中间件钩子可以插入执行过程。
两者现在的分工如下：</p>
<table header-row="true">
<tr>
<td>维度</td>
<td>LangChain（高层框架）</td>
<td>LangGraph（底层运行时）</td>
</tr>
<tr>
<td>定位</td>
<td>有明确默认方案的 Agent 框架</td>
<td>低层编排运行时</td>
</tr>
<tr>
<td>控制流</td>
<td>标准 Agent 循环 + 中间件钩子</td>
<td>`StateGraph` 自定义循环状态图（Pregel 超步模型）</td>
</tr>
<tr>
<td>状态</td>
<td>复用底层能力，开箱即用</td>
<td>原生 channel + checkpointer，可精细控制</td>
</tr>
<tr>
<td>上手成本</td>
<td>几行代码即可启动</td>
<td>需要理解图、节点、边和状态规约</td>
</tr>
<tr>
<td>能力来源</td>
<td>运行在 LangGraph 上</td>
<td>提供执行能力</td>
</tr>
</table>
<p>它们不是互相替代的两个框架，而是同一套技术栈的两层。LangChain 给出默认做法，LangGraph 允许开发者接管控制流。</p>
<h2 id="三现在怎么选">三、现在怎么选</h2>
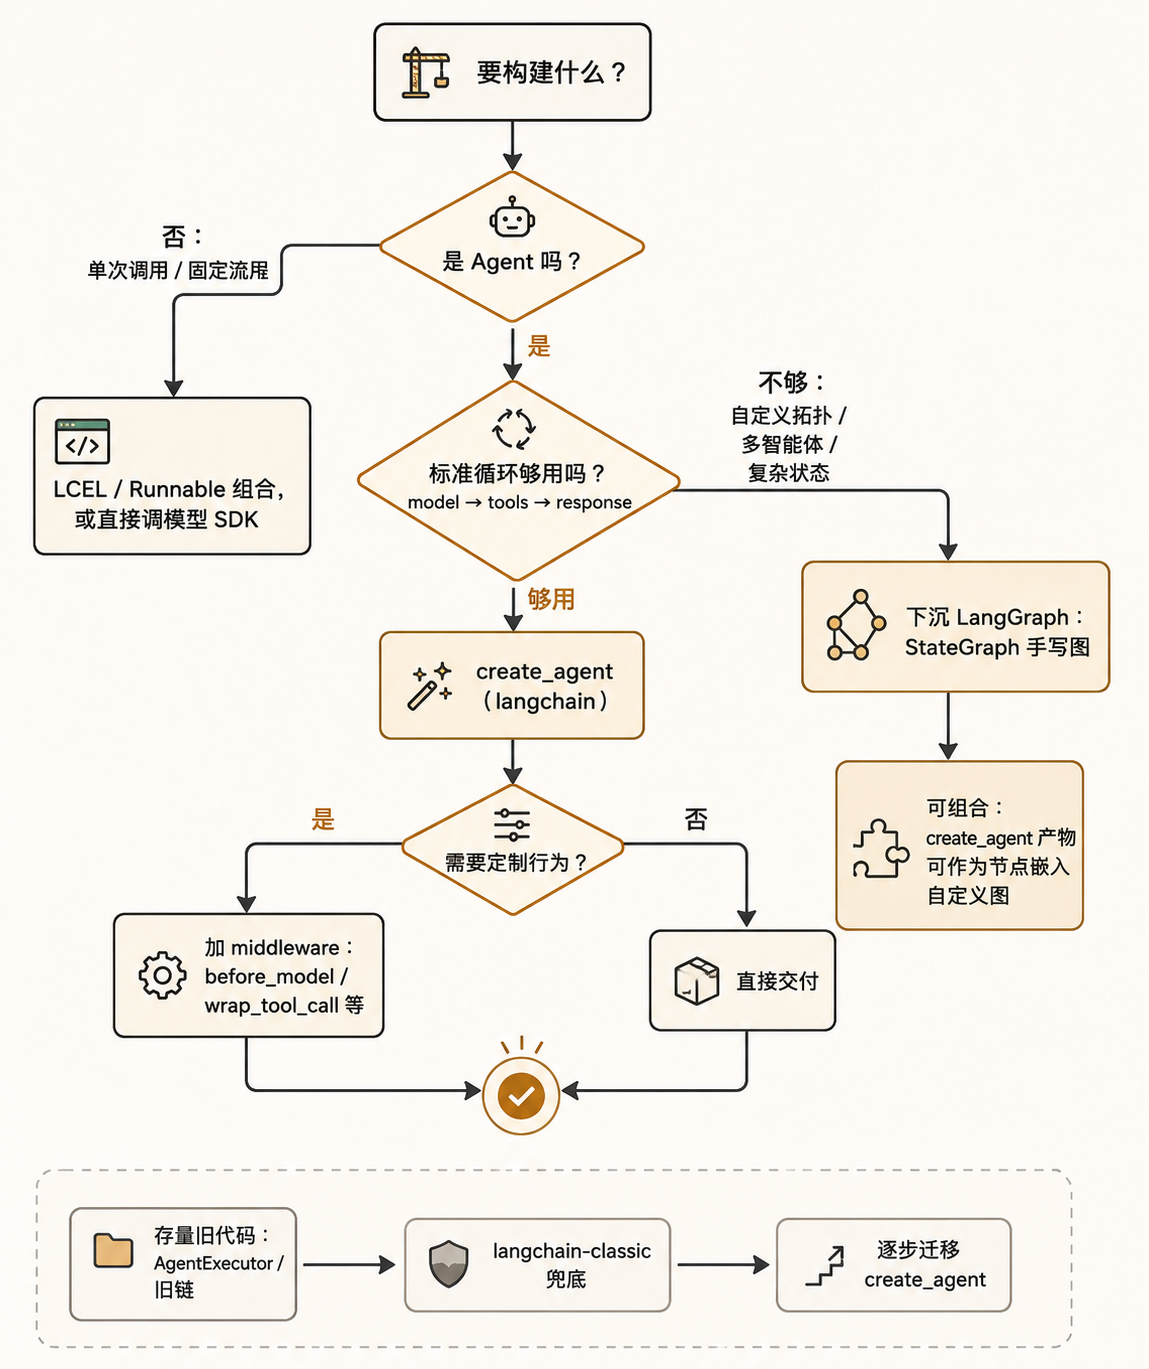
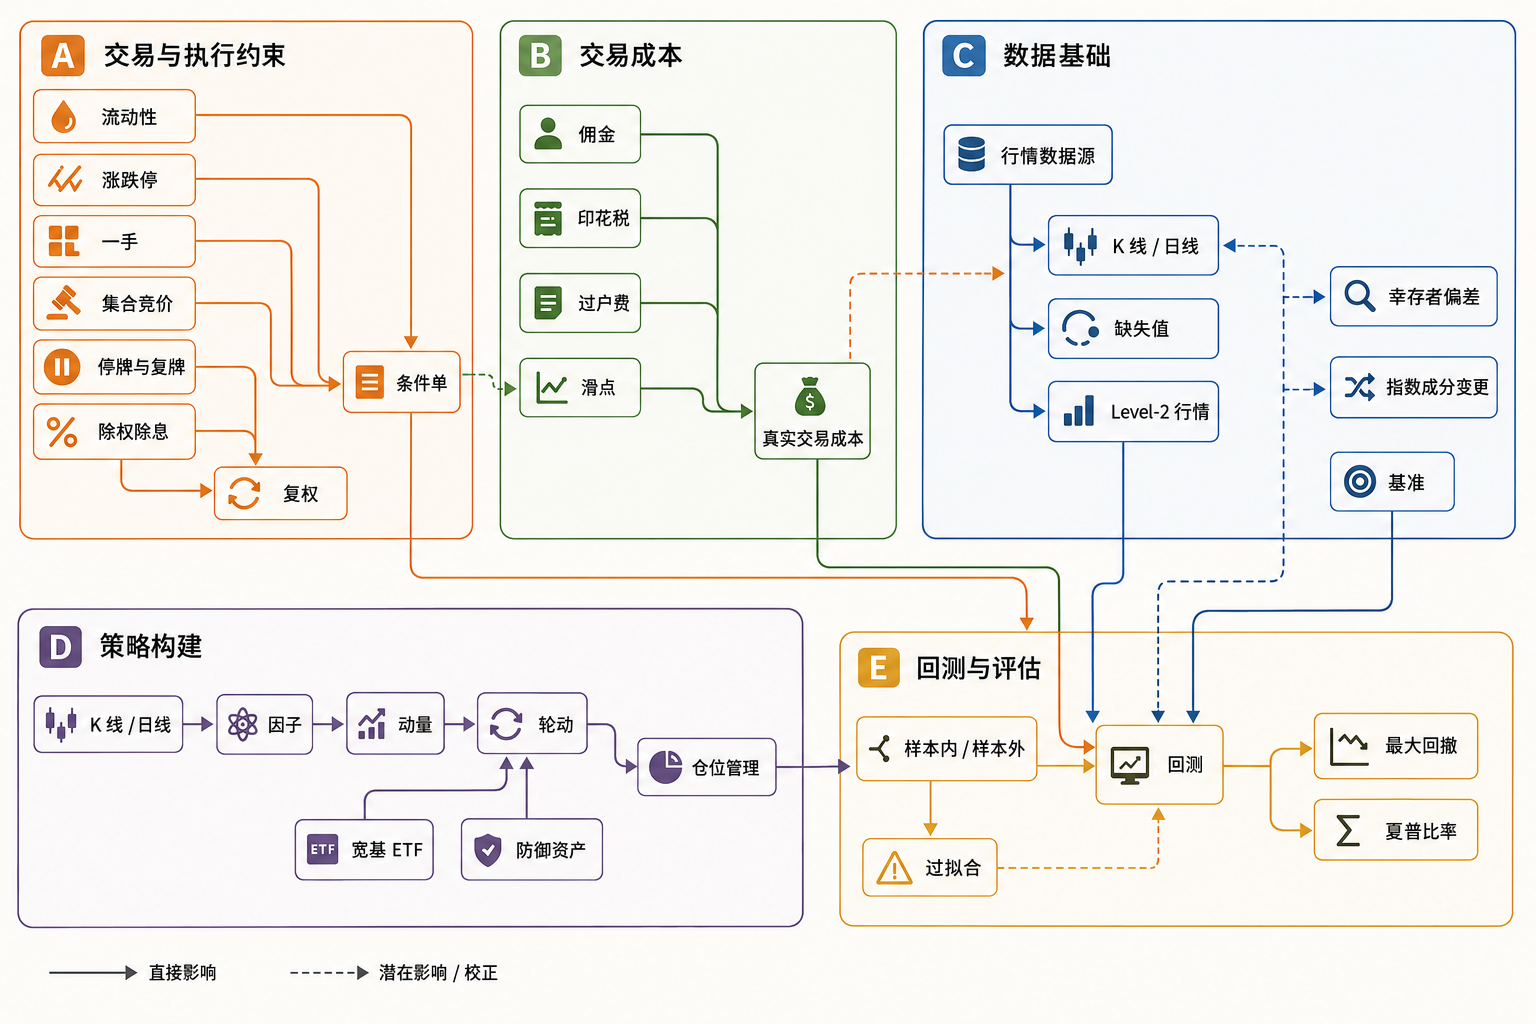
<p>我的判断标准很简单：当前需求能不能被「模型调用工具的标准循环」覆盖。能，就留在 LangChain；不能，再下沉到 LangGraph。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-25-langchain-langgraph/02.png" alt="" />
如果根本不是 Agent，比如单次问答、批量翻译或固定流程的数据处理，LCEL 已经够用。有些任务直接调用模型 SDK 反而更省事。没必要为了使用 Agent 而增加一层抽象。
大多数 Agent 业务都属于标准循环。先用 <code class="language-plaintext highlighter-rouge">create_agent</code>，遇到定制需求再加中间件。我不建议一开始就手写图，因为每多一分控制权，也会多一分开发和维护成本。
当流程包含自定义拓扑、多智能体协同、回退纠错或复杂状态机时，标准循环就装不下了。这时再用 LangGraph 手写 <code class="language-plaintext highlighter-rouge">StateGraph</code>，理由会更充分。
旧项目不用立刻重写。<code class="language-plaintext highlighter-rouge">langchain-classic</code> 可以先兜底，但它只维护关键 bug，迁移到 <code class="language-plaintext highlighter-rouge">create_agent</code> 应该放进计划里。
还有一点很实用：<code class="language-plaintext highlighter-rouge">create_agent</code> 的产物本身就是一张编译图，可以作为节点嵌入自定义 LangGraph 工作流。项目完全可以从高层起步，复杂以后再下沉，不必推倒重来。</p>]]></content><author><name>王翊仰</name></author><category term="LangChain" /><category term="AI Agent" /><summary type="html"><![CDATA[很多人还是分不清 LangChain 和 LangGraph]]></summary></entry><entry><title type="html">从 Agent Loop 到自进化：Hermes 有哪些是我们可以抄的</title><link href="https://www.wangyiyang.cc/2026/07/23/agent-loop-hermes/" rel="alternate" type="text/html" title="从 Agent Loop 到自进化：Hermes 有哪些是我们可以抄的" /><published>2026-07-23T00:00:00+08:00</published><updated>2026-07-23T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/23/agent-loop-hermes</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/23/agent-loop-hermes/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-23-agent-loop-hermes/01.png" alt="" /></p>

<p>最近 Nous Research 的 Hermes Agent 挺火，官网把它称为“会随你成长”的 Agent。我不太关心这句宣传语，真正让我停下来翻源码的是两个问题：它的 loop 到底怎么跑？它说的“自进化”，最后改动的究竟是什么？</p>

<p>这件事还有一点前情。在 <a href="https://www.wangyiyang.cc/2026-07-08/agent-loop.html">《Agent Loop 的文章好写》</a> 结尾，我建议想学 Agent Loop 的人先看 OpenClaw 和它的内核 pi，不要急着从零手搓。这个建议没变。但轮到我给 OPc 做执行 core 时，主要参照物却换成了 Hermes。</p>

<p>先说最现实的问题。OpenClaw 和 Hermes 都大量依赖 agent + skill：Skill 是自然语言，缺少稳定契约，也很难做回归；Hermes 还允许后台 LLM 自己判断何时创建或修改技能。出了问题，排查链路会很长。我在 <a href="https://www.wangyiyang.cc/2026-04-09/当-AI-学会了你的-Skill，你还剩下什么.html">《当 AI 学会了你的 Skill，你还剩下什么》</a> 里已经踩过这类坑，所以这次更想把能确定的执行过程写成程序，把模型留在真正需要判断的位置。</p>

<p>另一个原因是系统形态。pi 是 TS monorepo 里的嵌入式库，和前端运行时靠得很近。我的设想则是把 core 做成 headless 服务，CLI、IM 和 Web 只是不同入口。以后 OPc 真要从自用工具变成多人系统，也不用再拆一次前后端。Hermes 的 Python <code class="language-plaintext highlighter-rouge">AIAgent</code> 正好提供了一个更接近这个方向的样本。</p>

<p>下面不是一份完整的 Hermes 源码导读。我只拆跟这次架构选择有关的部分，也会明确写出哪些地方准备借鉴，哪些地方我不会照搬。</p>

<h1 id="一loop它没有pi">一、Loop：它没有”pi”</h1>

<p>OpenClaw 的核心 loop 来自独立的 pi（pi-agent-core + pi-ai）：Read、Write、Edit、Bash 四个基础工具，再加一套扩展系统。Hermes 没有抽出一个对应的“pi”，loop 就写在主仓库里。顺着调用链看，核心集中在两处：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">run_agent.py</code> 里的 <code class="language-plaintext highlighter-rouge">AIAgent</code> 类，负责整个 “Think–Act–Observe” 循环，而且平台无关——CLI、消息网关、ACP 共用同一个 loop</li>
  <li><code class="language-plaintext highlighter-rouge">agent/conversation_loop.py</code> 里的 <code class="language-plaintext highlighter-rouge">run_conversation</code>，管单轮对话的主循环（模型调用、工具分发、重试、fallback、上下文压缩）</li>
</ul>

<p>一轮 loop 大致是这样走的：</p>

<ol>
  <li>把用户消息追加到会话历史</li>
  <li>构建 / 复用缓存的 system prompt</li>
  <li>上下文超过 50% 就先做一次压缩</li>
  <li>按三种 API 模式之一组装消息：<code class="language-plaintext highlighter-rouge">chat_completions</code> / <code class="language-plaintext highlighter-rouge">codex_responses</code> / <code class="language-plaintext highlighter-rouge">anthropic_messages</code>（内部统一成 OpenAI 兼容格式）</li>
  <li>注入临时 prompt 层（预算警告、上下文压力等），Anthropic 模式下加 prompt caching 标记</li>
  <li>发起一次”可中断的” API 调用</li>
  <li>看响应：有 tool_calls 就执行工具、把结果塞回历史、回到第 4 步继续循环；纯文本就持久化会话、必要时刷新记忆，然后返回</li>
</ol>

<p>画成流程图更直观：</p>

<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-23-agent-loop-hermes/02.png" alt="" /></p>

<p>落到代码上，主循环大致长这样（基于 <code class="language-plaintext highlighter-rouge">agent/conversation_loop.py</code> 的源码做了简化，非逐行原文）：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># agent/conversation_loop.py · run_conversation 主循环（简化版）
</span><span class="k">while</span> <span class="n">api_call_count</span> <span class="o">&lt;</span> <span class="n">agent</span><span class="p">.</span><span class="n">max_iterations</span> <span class="ow">and</span> <span class="p">(</span>
    <span class="n">agent</span><span class="p">.</span><span class="n">iteration_budget</span><span class="p">.</span><span class="n">remaining</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="ow">or</span> <span class="n">agent</span><span class="p">.</span><span class="n">_budget_grace_call</span>
<span class="p">):</span>
    <span class="n">api_call_count</span> <span class="o">+=</span> <span class="mi">1</span>

    <span class="c1"># ① 调模型前先看上下文要不要压缩
</span>    <span class="k">if</span> <span class="n">agent</span><span class="p">.</span><span class="n">compression_enabled</span> <span class="ow">and</span> <span class="n">_compressor</span><span class="p">.</span><span class="n">should_compress</span><span class="p">(</span><span class="n">_real_tokens</span><span class="p">):</span>
        <span class="n">messages</span> <span class="o">=</span> <span class="n">agent</span><span class="p">.</span><span class="n">_compress_context</span><span class="p">(</span><span class="n">messages</span><span class="p">)</span>

    <span class="c1"># ② 发起一次可中断的 API 调用（内部统一成 OpenAI 兼容格式）
</span>    <span class="n">response</span> <span class="o">=</span> <span class="n">client</span><span class="p">.</span><span class="n">chat</span><span class="p">.</span><span class="n">completions</span><span class="p">.</span><span class="n">create</span><span class="p">(</span>
        <span class="n">model</span><span class="o">=</span><span class="p">...,</span> <span class="n">messages</span><span class="o">=</span><span class="n">messages</span><span class="p">,</span> <span class="n">tools</span><span class="o">=</span><span class="p">...)</span>
    <span class="n">assistant_message</span> <span class="o">=</span> <span class="n">response</span><span class="p">.</span><span class="n">choices</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">message</span>

    <span class="c1"># ③ 有 tool_calls → 执行工具，把结果塞回历史，回到循环顶部
</span>    <span class="k">if</span> <span class="n">assistant_message</span><span class="p">.</span><span class="n">tool_calls</span><span class="p">:</span>
        <span class="n">results</span> <span class="o">=</span> <span class="n">agent</span><span class="p">.</span><span class="n">_execute_tool_calls</span><span class="p">(</span><span class="n">assistant_message</span><span class="p">.</span><span class="n">tool_calls</span><span class="p">)</span>
        <span class="n">messages</span><span class="p">.</span><span class="n">extend</span><span class="p">(</span><span class="n">results</span><span class="p">)</span>
        <span class="k">continue</span>

    <span class="c1"># ④ 纯文本 → 持久化会话、必要时刷新记忆，返回最终回复
</span>    <span class="k">break</span>
</code></pre></div></div>

<p>工具系统也是自己写的：中央注册表 <code class="language-plaintext highlighter-rouge">ToolRegistry</code> 在 <code class="language-plaintext highlighter-rouge">tools/registry.py</code> 里，<code class="language-plaintext highlighter-rouge">model_tools.py</code> 启动时扫描 <code class="language-plaintext highlighter-rouge">tools/</code> 目录并 import，每个工具文件在 import 时自注册（<code class="language-plaintext highlighter-rouge">registry.register()</code>）。注册入口就是模块顶层的一次函数调用：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># tools/clarify_tool.py —— 模块顶层直接自注册
</span><span class="n">registry</span><span class="p">.</span><span class="n">register</span><span class="p">(</span>
    <span class="n">name</span><span class="o">=</span><span class="s">"clarify"</span><span class="p">,</span>
    <span class="n">toolset</span><span class="o">=</span><span class="s">"clarify"</span><span class="p">,</span>
    <span class="n">schema</span><span class="o">=</span><span class="n">CLARIFY_SCHEMA</span><span class="p">,</span>
    <span class="n">handler</span><span class="o">=</span><span class="k">lambda</span> <span class="n">args</span><span class="p">,</span> <span class="o">**</span><span class="n">kw</span><span class="p">:</span> <span class="n">clarify_tool</span><span class="p">(</span>
        <span class="n">question</span><span class="o">=</span><span class="n">args</span><span class="p">.</span><span class="n">get</span><span class="p">(</span><span class="s">"question"</span><span class="p">,</span> <span class="s">""</span><span class="p">),</span>
        <span class="n">choices</span><span class="o">=</span><span class="n">args</span><span class="p">.</span><span class="n">get</span><span class="p">(</span><span class="s">"choices"</span><span class="p">),</span>
        <span class="n">callback</span><span class="o">=</span><span class="n">kw</span><span class="p">.</span><span class="n">get</span><span class="p">(</span><span class="s">"callback"</span><span class="p">)),</span>
    <span class="n">check_fn</span><span class="o">=</span><span class="n">check_clarify_requirements</span><span class="p">,</span>
    <span class="n">emoji</span><span class="o">=</span><span class="s">"❓"</span><span class="p">,</span>
<span class="p">)</span>
</code></pre></div></div>

<p>发现机制也很直白：先用 AST 静态判断文件里有没有顶层 <code class="language-plaintext highlighter-rouge">registry.register()</code> 调用，再 import——import 即注册：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># tools/registry.py —— 扫描 tools/ 目录，import 即注册（节选）
</span><span class="k">def</span> <span class="nf">discover_builtin_tools</span><span class="p">(</span><span class="n">tools_dir</span><span class="p">:</span> <span class="n">Optional</span><span class="p">[</span><span class="n">Path</span><span class="p">]</span> <span class="o">=</span> <span class="bp">None</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">List</span><span class="p">[</span><span class="nb">str</span><span class="p">]:</span>
    <span class="n">module_names</span> <span class="o">=</span> <span class="p">[</span>
        <span class="sa">f</span><span class="s">"tools.</span><span class="si">{</span><span class="n">path</span><span class="p">.</span><span class="n">stem</span><span class="si">}</span><span class="s">"</span>
        <span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="nb">sorted</span><span class="p">(</span><span class="n">tools_path</span><span class="p">.</span><span class="n">glob</span><span class="p">(</span><span class="s">"*.py"</span><span class="p">))</span>
        <span class="k">if</span> <span class="n">path</span><span class="p">.</span><span class="n">name</span> <span class="ow">not</span> <span class="ow">in</span> <span class="p">{</span><span class="s">"__init__.py"</span><span class="p">,</span> <span class="s">"registry.py"</span><span class="p">,</span> <span class="s">"mcp_tool.py"</span><span class="p">}</span>
        <span class="ow">and</span> <span class="n">_module_registers_tools</span><span class="p">(</span><span class="n">path</span><span class="p">)</span>  <span class="c1"># AST 判断，不用真的 import
</span>    <span class="p">]</span>
    <span class="k">for</span> <span class="n">mod_name</span> <span class="ow">in</span> <span class="n">module_names</span><span class="p">:</span>
        <span class="n">importlib</span><span class="p">.</span><span class="n">import_module</span><span class="p">(</span><span class="n">mod_name</span><span class="p">)</span>  <span class="c1"># import 时触发 registry.register()
</span></code></pre></div></div>

<p>两条路线的差别很直接。OpenClaw 把独立的 pi 包起来，接到多个渠道；Hermes 自己维护整套平台无关的 loop。pi 更小、更容易复用，Hermes 则把多 provider 和多平台的控制权留在自己手里。代价也摆在明面上：后者要维护的东西更多。</p>

<h1 id="二自进化两层别混为一谈">二、自进化：两层，别混为一谈</h1>

<p>“Self-improving”很容易说成玄学。源码里的实现没有那么神秘：一套机制在运行时整理技能和记忆，另一套机制离线读取轨迹、做优化，再走人工审核。先看它们怎么接在一起：</p>

<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-23-agent-loop-hermes/03.png" alt="" /></p>

<h2 id="第一层运行时学习闭环内置">第一层：运行时学习闭环（内置）</h2>

<p>日常对话中的“学习”，主要发生在后台复盘里。</p>

<ul>
  <li>默认每 10 条用户消息，或者单轮累计 10 次工具调用，<code class="language-plaintext highlighter-rouge">_spawn_background_review</code> 会启动一个 daemon 线程。线程里另起 <code class="language-plaintext highlighter-rouge">review_agent</code>，用专门的 prompt 回看这段对话，寻找用户纠错、可复用技巧和已经过时的技能。</li>
  <li>这个 fork 只能使用 memory 和 skill 管理工具，而且设置了 <code class="language-plaintext highlighter-rouge">_persist_disabled=True</code>。它的复盘过程不会混进用户会话，只能把结果写到技能或记忆存储。</li>
  <li>发现值得保留的做法后，它会通过 <code class="language-plaintext highlighter-rouge">skill_manage</code> 创建或局部修改技能，文件放在 <code class="language-plaintext highlighter-rouge">~/.hermes/skills/</code>。只有后台复盘创建的技能才会标记为 <code class="language-plaintext highlighter-rouge">created_by: agent</code>；用户在前台主动创建的不会被算进去：</li>
</ul>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># tools/skill_manage 内部（简化）
</span><span class="k">if</span> <span class="n">is_background_review</span><span class="p">():</span>
    <span class="n">mark_agent_created</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>  <span class="c1"># Curator 后续只巡检这些 agent-created 技能
</span></code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">MEMORY.md</code> 和 <code class="language-plaintext highlighter-rouge">USER.md</code> 保存长期事实与用户信息，每轮都会注入，但规则明确要求它不要记录临时任务进度。跨会话回忆走 FTS5 全文检索，再由 LLM 做摘要。</p>

<p>技能写出来之后也不是放着不管。Curator 会定期检查 agent 自建的技能：长期不用的标成 stale，确认废弃的移入归档，内容重叠的尝试合并。它不直接删除技能，这一点我觉得比“自动清理”四个字听起来克制得多。</p>

<p>所以 Hermes 的在线学习更像维护一套会变化的工作笔记，而不是在运行时训练模型。</p>

<h2 id="第二层dspy--gepa-离线进化独立仓库">第二层：DSPy + GEPA 离线进化（独立仓库）</h2>

<p>另一套机制放在独立仓库 <code class="language-plaintext highlighter-rouge">hermes-agent-self-evolution</code>，不参与实时对话。它读取执行轨迹，定位失败原因，生成候选修改，最终以 PR 的形式回到主仓库。</p>

<p>这里我很熟悉。在 <a href="https://www.wangyiyang.cc/2026-06-12/我把一个-Skill-从手写-Prompt-重构成了可编译模块-一次-DSPy-实战复盘.html">《我把一个 Skill 从手写 Prompt 重构成了可编译模块》</a> 里，我用 DSPy 把 Skill 中靠手感调整的措辞变成可以评估、回归和重新编译的参数。Hermes 做的是同一类事，只是目标从单个 Skill 扩大到了 prompt、工具描述和其他 agent 组件。</p>

<ol>
  <li>选定目标（某个技能 / prompt 片段 / 工具）</li>
  <li>构建评估数据集（LLM 合成 + 挖真实会话历史 + 人工 golden 集）</li>
  <li>把目标文本包装成 DSPy 模块，让”指令”变成可学习参数</li>
  <li>跑 <code class="language-plaintext highlighter-rouge">dspy.GEPA</code>（Genetic-Pareto Prompt Evolution）优化，不可用时降级到 MIPROv2</li>
  <li>在留出测试集上和 baseline 比</li>
  <li><strong>人工审核后</strong>通过 Git PR 合并，绝不热更新到进行中的对话</li>
</ol>

<p>GEPA 不只接收一个失败分数，还会分析轨迹里的失败原因，再让推理模型提出有针对性的文本变体。候选结果要经过留出测试集，以及 TBLite、TerminalBench2、YC-Bench 等回归检查。整个过程调整的是文本，不是模型权重，因此只需要 API 调用，不需要自己准备 GPU 训练。</p>

<h1 id="三哪些我会抄哪些不会">三、哪些我会抄，哪些不会</h1>

<p>我会抄它的分层：前台 loop 只负责把当前任务跑完；后台复盘负责沉淀技能和记忆；更激进的优化放到离线流程里，经过评估和人工审核再合并。这三件事的风险不同，没必要塞进同一个“自进化”开关。</p>

<p>我也会保留 PR + 人审这条边界。让 agent 生成修改不难，难的是阻止一次看似有效的修改悄悄破坏其他任务。Hermes 不在进行中的会话里热更新，这比“能够自动改自己”更值得抄。</p>

<p>我不会照搬它让 LLM 直接维护自然语言 Skill 的方式。至少在 OPc 里，能写成确定性程序的步骤仍然应该写成程序；Skill 更适合负责判断、选择和解释。否则系统用得越久，技能目录越大，问题只会从“模型偶尔不稳定”变成“没人知道它为什么这么做”。</p>

<p>至于自研 loop，我现在的判断也更保守了。Hermes 证明这条路能换来 provider 和平台层面的控制力，但同时也展示了维护成本：重试、fallback、压缩、工具并发、持久化和中断处理，一个都省不掉。是否值得抄，取决于你究竟需要多少控制权。</p>]]></content><author><name>王翊仰</name></author><category term="AI Agent" /><summary type="html"><![CDATA[承接《Agent Loop 的文章好写》结尾对 OpenClaw/pi 的推荐，回答"真要给 OPc 自研执行 core 时为什么参照物换成 Hermes"：一是 agent + skill 形态太黑盒，要把可控执行程序化；二是要前后端分离，不被前端 TS 体系主导。正文拆 Hermes 自研 loop 和两层自进化（运行时闭环 + DSPy/GEPA 离线进化），落点是"哪些直接抄、哪些反着做"]]></summary></entry><entry><title type="html">读完两代源码，我想聊聊 Kimi Code CLI 的架构取舍</title><link href="https://www.wangyiyang.cc/2026/07/19/kimi-code-cli/" rel="alternate" type="text/html" title="读完两代源码，我想聊聊 Kimi Code CLI 的架构取舍" /><published>2026-07-19T00:00:00+08:00</published><updated>2026-07-19T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/19/kimi-code-cli</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/19/kimi-code-cli/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-19-kimi-code-cli/01.jpg" alt="Kimi Code CLI 源码与架构主题封面" />
Kimi K3 发布那天，我的时间线被刷屏了，跑分截图和长文解读一茬接一茬。
我在干一件不太合群的事：把同一家公司另一个仓库 clone 下来，读源码。
那个仓库叫 <a href="https://github.com/MoonshotAI/kimi-code">kimi-code</a>，月之暗面的终端 Agent，Kimi Code CLI。读完两代源码，我的结论是：<strong>这是国货之光，诚意都写在仓库里。</strong>
模型的热闹大家都在看，这个安静的工具却少有人聊。下面只挑读源码时真正让我心动的地方讲。</p>
<h2 id="我先看见的是取舍">我先看见的是取舍</h2>
<p>我读这个仓库时，最在意的不是功能数量，而是团队主动放弃了什么。
先说开放性。让我意外的不是它支持 MCP 和 ACP，这些在今天的编程 Agent 里是标配，而是团队没有趁机再造一套私有插件格式。skill、MCP server、数据源都从开放标准装进来，来源可以是官方市场，也可以是任意一个 GitHub 仓库。
这个选择换来的工程收益，值得展开说两句。最直接的是隔离：工具跑在 MCP server 的独立进程里，隔着协议和内核通信，工具崩溃、依赖冲突都传不进 Agent 内核，内核也不需要为任何具体工具写一行适配代码。分发成本也被压到很低，skill 就是仓库里的一组文件，装扩展等于 clone 一个 repo，不用打包、签名、过审核，社区里现成的 MCP server 第一天就能接上。还有一笔长期账：插件格式的规范、版本演进和兼容性包袱由开放标准共同承担，团队不用独自养一套私有格式的文档、SDK 和迁移工具。
这会让用户更容易迁移，也意味着工具必须靠体验留人。团队接受了这个风险。
然后是一次很彻底的重写。第一代 <a href="https://github.com/MoonshotAI/kimi-cli">kimi-cli</a> 用 Python 开发，已经攒下 9.5k stars。这个体量的项目，继续修补是更容易解释的选择。他们却改用 TypeScript 重写成现在的 kimi-code，同时提供迁移工具，让老用户用一条命令带走配置、MCP 和会话历史。
在已有 9.5k stars 的项目上决定重写，比从零启动更难交代。更打动我的是，他们没有把迁移成本扔给老用户。
开源的处理也类似。kimi-code 采用 MIT 协议，从 Agent 内核到 TUI 都能看到源码，kosong（LLM 抽象层）、kaos 等基础件还被拆成独立包发布。单二进制、毫秒级启动、视频输入这些特性我不展开了。相比功能清单，我更在意这个团队愿意把关键实现放到开发者面前。</p>
<h2 id="再往代码里走一层">再往代码里走一层</h2>
<p>我读代码库习惯先找边界。kimi-code 的 packages/ 目录没有让我来回猜：界面、事件流、Agent 内核和模型抽象各自待在自己的位置，依赖关系也能顺着目录读下去。
先上一张全景图：
<img src="https://www.wangyiyang.cc/images/posts/2026-07-19-kimi-code-cli/02.png" alt="Kimi Code CLI 整体架构图" />
<em>图：Kimi Code CLI（kimi-code，TypeScript 版）整体架构。官方未提供架构图，本图根据仓库 packages/ 结构与源码整理绘制。</em>
kimi-code 的 Agent 内核不直接画界面，只对外吐一条 wire 事件流。TUI 和 Web 界面消费这条流，IDE 则通过适配层接进来。它们共用一套内核，不需要互相知道对方的存在。这个边界的好处在加新前端时最明显：内核一行不用改，新界面只要会消费事件流就能接上。排查问题也省力，事件流就是内核和界面之间的完整对账单，bug 落在哪一侧，对着流看一眼就知道。
会话本身也是 wire.jsonl 事件日志。回放日志就能恢复现场，持久化和调试因此落在同一套机制里。含金量在出问题时才显出来：复现 bug 不需要用户描述操作步骤，一份 wire.jsonl 扔过来，本地回放就能停在出错前的任意一刻；进程崩溃后的恢复也不用单写快照逻辑，重放日志本身就是恢复。事件溯源在教科书里讲了很多年，在一个终端工具中看到这么完整的实现，我停下来读了好一会儿。
长会话的处理是另一个细节。coder、explore、plan 各自持有独立上下文，完成任务后只把结论交回主对话。中间的搜索和尝试不会全部挤进主上下文，这比单纯调大上下文窗口更合我的胃口。真正的收益是主对话的信噪比不随任务变长而衰减：explore 翻过的几十个文件、coder 失败的中间尝试，都在各自的上下文里生灭，主对话只沉淀结论。长任务后期模型「忘了最初要干什么」的老毛病，很大程度上就是被这个结构压住的。
把镜头再拉远，packages/ 下能看到 agent-core、kosong、kaos、acp-adapter 和 protocol。它们各自有版本和文档，不只是为了整理目录才拆开。拆开的实际好处是复用和替换有了边界：想在自己的项目里拿 kosong 做模型层抽象，不必背走整个 CLI；内核迭代时，protocol 包锁住的接口契约也让各端不至于跟着一起震动。知乎上有工程师评价这套代码「质量非常高，值得研读」。我读过之后，基本同意。</p>
<h2 id="代码里的浪漫">代码里的浪漫</h2>
<p>架构之外，这个团队还藏了些彩蛋。
第一代 kimi-cli 的 checkpoint 回滚机制叫 D-Mail，取自《命运石之门》里往过去发送的短信。回滚会话状态，可不就是给过去的自己发一条消息吗。
再往下翻还有：第一代用 Python 类型注解做工具依赖注入，inspect.signature 读函数签名自动装配，没有引任何重型框架；第二代换成 pnpm monorepo，oxlint、vitest、changesets 摆得整整齐齐。语言换了，那股认真劲儿没换。</p>
<h2 id="写在最后">写在最后</h2>
<p>「国货之光」这个词被用滥了，这次我用得心安理得。MIT 协议下完全摊开的代码，拆出来回馈社区的基础件，给老用户修好的迁移之桥，这些都不是口号，是仓库里看得见的东西。
想上手的，官网一行命令的事。我真正想安利的是把源码 clone 下来读一读，看看一个认真的工程团队，是怎么把诚意写进每一个 commit 的。</p>
<details>
<summary>📋 发布前自检记录（2026-07-19）</summary>
	**快速测试**：① 抽走引用测试通过，引用仅知乎一句评价 + README 事实，占比远低于 20%，观点主体是作者本人，判定「轻改即可、无需重构」；② 指纹密度测试未通过，初稿加粗金句 7 处、破折号补刀 10+ 处、三连排比 5 处，已全文去味。
	**命中模式与改法**：加粗金句（如「不靠私有格式锁用户，靠标准赢生态」）仅保留开头定调句 1 处；破折号改逗号句号；三连排比（「完全开源、源码漂亮、工程师文化有趣」）删除或改事实列举；否定式排比由 4 处减至 2 处；「粗体标题：解释」式列表（代码里的浪漫一节）合并为叙述段；金句收尾（「工程师的浪漫，都藏在命名里」等）删减过半。
	**结构调整**：ACP 只保留为一句背景事实，不再作为卖点。二次复核时发现「三个舍得」「三个模式，三个故事」以及连续六个小标题过于整齐，已删除计数式框架和对应小标题，改成有轻重变化的连续叙述；同时压平「围墙能……标准才……」等判断式金句。
	**独家料（均真实）**：① 两代源码对读细节（inspect.signature 依赖注入、packages/ 结构）；② D-Mail 彩蛋出处；③ 上一篇纯架构解读阅读量 57 的真实数据（已写入开头）。
	**质量评分**：直接性 9 / 节奏 9 / 信任度 9 / 真实性 9 / 精炼度 10，总分 46/50，达到可交稿线。
</details>]]></content><author><name>王翊仰</name></author><category term="CLI" /><category term="AI Agent" /><summary type="html"><![CDATA[真诚安利文：以「高级产品经理 + 资深架构师」双重视角审视 Kimi Code CLI，把自己真心觉得好的地方写出来——产品判断与取舍、架构品味、有趣的工程师文化。国货之光，诚意都在仓库里。【红线：不提 harness / token 对比；不写使用教程】]]></summary></entry><entry><title type="html">A 股个人量化的真实边界：数据、券商与交易规则</title><link href="https://www.wangyiyang.cc/2026/07/16/a-gu-ge-ren-liang-hua-zhen-shi-bian-jie/" rel="alternate" type="text/html" title="A 股个人量化的真实边界：数据、券商与交易规则" /><published>2026-07-16T00:00:00+08:00</published><updated>2026-07-16T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/16/a-gu-ge-ren-liang-hua-zhen-shi-bian-jie</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/16/a-gu-ge-ren-liang-hua-zhen-shi-bian-jie/"><![CDATA[<blockquote>
  <p>AI 量化学习笔记 · 第 2 篇</p>
</blockquote>

<p>第 0 篇讲了我为什么开始看量化，上一篇把 30 个基础概念过了一遍。这一篇进入正题：在中国境内，一个普通工程师用个人账户做量化，边界到底在哪。
写这篇之前我做了一轮调研，翻了券商的推广材料、知乎和几个第三方量化站点，也整理了一份准备逐家问客户经理的问题清单。先说明：下面涉及门槛和政策的数字都来自网络公开渠道，不同营业部差异很大，我还没拿到书面确认。等答复回来，有出入我会在后续文章里修正。</p>
<h2 id="策略在哪里跑三种终端">策略在哪里跑：三种终端</h2>
<p>个人做程序化交易，绕不开券商提供的终端。目前主流是三个：</p>
<ul>
  <li><strong>QMT</strong>（迅投）：本地 Windows 运行，内置编辑器写 Python。</li>
  <li><strong>miniQMT</strong>：QMT 的极简模式，通过 xtquant 在外部 Python 调用。本地任意 IDE，可以装第三方库，自由度最高。</li>
  <li><strong>PTrade</strong>（恒生电子）：策略上传后跑在券商服务器上，不依赖本地开机；代价是平台内 Python 不支持第三方库，也不能访问外网。
对我这种低频 ETF 路线，两条路都够用。差别主要在两点：miniQMT 最贴合我「研究层不绑定券商」的想法，但需要一台长期开机的 Windows 机；PTrade 云端运行，可以完全省掉执行机，代价是灵活度受限，而且策略代码存在券商服务器上。
还有一个时间敏感的动态：据第三方量化站点消息，2026 年 7 月 6 日起已有券商全面停止 miniQMT 新申请，存量用户后续也将逐步停服。这个消息的真假和范围我还要再确认，但它至少提醒我：这条路的窗口可能在收窄，调研得抢在前面。
调研的时候我把选型思路整理成了一棵决策树。它不只回答我自己的情况，之后再有人问「个人做量化该用什么」，我打算直接甩这张图：
<img src="https://www.wangyiyang.cc/images/posts/2026-07-16-a-gu-ge-ren-liang-hua-zhen-shi-bian-jie/01.png" alt="" />
按这棵树走一遍我自己的情况：A 股 ETF 中低频、资金能凑到门槛、每周能投十小时以上、要第三方 Python 库——落在 QMT / miniQMT 这一支，但「是否仍开放」正好卡在前面说的停申动态上。所以我目前的选择是：优先联系同时支持 QMT 和 PTrade 的券商，两条路都留着。
    <h2 id="门槛没有传说中高但水很深">门槛没有传说中高，但水很深</h2>
    <p>2026 年个人开通 QMT 的门槛放宽了不少：部分券商 10 万验资，加签一份量化交易风险协议，审核一到三个工作日。miniQMT 常见说法是 10 万（按 20 日日均资产计），但也有券商要 50 万甚至 100 万。PTrade 约 10 万，支持的券商比较少。
几个容易踩的细节：</p>
  </li>
  <li>多数开通要求新开户，已有账户能不能加挂要逐家问。</li>
  <li>是否允许策略跑在云主机上，各家政策不同，个别券商明确不支持。</li>
  <li>门槛资金不等于建议投入金额。我的计划是实盘验证只用 3,000 到 10,000 元，门槛资金放国债逆回购或货币基金这类低风险仓位。
我把要客户经理书面确认的问题整理成了一份清单，十来条。列几条关键的：miniQMT 是否仍接受新申请、个人账户版本有没有功能阉割、仿真账户怎么开、程序化交易报备流程是什么、断线后订单和策略怎么恢复。还有一个快速自查法：拿到某券商的 QMT 客户端后，看登录界面有没有「极简模式」选项，有就是支持 miniQMT，没有就是被阉割的版本。
    <h2 id="数据不要钱但要交叉核对">数据不要钱，但要交叉核对</h2>
    <p>研究环境这一层完全不用花钱。akshare、tushare、baostock 都能免费拉 A 股和 ETF 的历史行情，我的做法是关键数据用两个来源交叉核对。日线级别的计算量很小，一台 MacBook 就能覆盖数据拉取、回测和因子研究，Windows 执行机可以推迟到仿真阶段再落地，到时候优先租云主机低成本试错。
真正贵的不是数据本身，是数据质量：缺失值、停牌、复权处理、指数成分变更，还有退市带来的幸存者偏差。回测里少处理一个，结论就可能是假的。</p>
    <h2 id="交易规则是回测的一部分">交易规则是回测的一部分</h2>
    <p>A 股的规则必须显式写进回测引擎，不然回测只是自我安慰：T+1、涨跌停、停复牌、除权除息与复权、最小交易单位，再加上佣金、印花税、过户费和滑点。
举个例子：一个靠涨停板次日卖出获利的策略，如果回测里不处理「涨停买不进、跌停卖不出」，数字会好看得离谱。这也是我第一阶段选宽基 ETF 的原因：规则简单、流动性好、容错高，先把回测到实盘的链路跑通，再切个股。
合规也是同一类问题：程序化交易需要报备，券商对异常委托和撤单有风控限制。这部分各家要求不一样，同样在问题清单里。</p>
    <h2 id="接下来做什么">接下来做什么</h2>
    <p>第一个项目已经定了：4 到 6 只宽基 ETF 的月度动量轮动。每月固定日期收盘后算过去 N 个月收益，选排名靠前的 1 到 2 只，设现金或债券 ETF 防御规则，纳入佣金和滑点，先做 5 年以上历史回测，再仿真，再小额实盘。它不复杂，但覆盖了数据、信号、组合、成交、风控和复盘的完整链路。
本周的任务是联系两三家客户经理，把清单逐项拿到书面答复。拿到之后，如果和本文的网传信息有出入，我会在下一篇里更正。
下一篇写研究环境搭建：akshare、duckdb，和第一张自己画出来的 510300 日线图。</p>
    <blockquote>
      <p>本系列不构成投资建议。文中门槛与政策信息均来自公开渠道，以券商书面答复为准。</p>
    </blockquote>
  </li>
</ul>]]></content><author><name>王翊仰</name></author><category term="AI 量化学习笔记" /><summary type="html"><![CDATA[A 股个人量化的真实边界：数据、券商与交易规则。从 QMT/miniQMT/PTrade 三种终端选型，到开户门槛和隐藏细节，再到数据质量和交易规则对回测的影响，最后落地第一个项目：宽基 ETF 月度动量轮动。]]></summary></entry><entry><title type="html">动手写策略之前，我先搞懂了这 30 个概念</title><link href="https://www.wangyiyang.cc/2026/07/15/30-concepts-before-trading-strategy/" rel="alternate" type="text/html" title="动手写策略之前，我先搞懂了这 30 个概念" /><published>2026-07-15T00:00:00+08:00</published><updated>2026-07-15T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/15/30-concepts-before-trading-strategy</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/15/30-concepts-before-trading-strategy/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-15-30-concepts-before-trading-strategy/01.png" alt="微信公众号封面图" /></p>
<blockquote>
  <p>AI 量化学习笔记 · 第 1 篇</p>
</blockquote>

<p>上一篇讲了我为什么开始看量化。这篇原本要写券商调研，但写到一半卡住了：QMT、滑点、复权、样本外……几乎每一段都得先解释名词。于是我停下来，把这几天反复查过的概念单独整理成一篇，数下来正好三十个。下面都是我现阶段的理解，有错我会回来改。
不用背。先扫一遍，后面的文章遇到哪个再回来查。</p>

<h2 id="关键词关系图">关键词关系图</h2>
<p>我刚开始记这些词时，它们是散的。整理完才看出顺序：先确认交易规则和数据能不能支持一个想法，再把成本算进去，最后才轮到回测和风险指标。顺序反了，很容易得到一个看起来不错、实际做不了的结果。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-15-30-concepts-before-trading-strategy/02.png" alt="" /></p>
<h2 id="交易规则先搞清楚哪些单会成交">交易规则：先搞清楚哪些单会成交</h2>
<ol>
  <li>流动性：一个标的能不能快速、低成本地成交。成交量小、买卖价差大的标的，即使策略信号再好，也可能因为买不进、卖不出或冲击成本太高而无法执行。回测时不能只看收盘价，还要给成交能力设限制。</li>
  <li>涨跌停：A 股会限制单日价格的最大波动范围，不同板块、证券状态和上市阶段的限制并不完全相同。对回测来说，真正重要的不是背下比例，而是处理「涨停时可能买不进、跌停时可能卖不出」：如果默认每天都能按收盘价成交，策略收益很容易被高估。</li>
  <li>一手：最小买入单位，100 股。买入必须整手，卖出可以有零股。写回测下单逻辑时要取整，不然会算出「买 137.5 股」这种成交。</li>
  <li>集合竞价：开盘前（9:15–9:25）和收盘前（14:57–15:00）的撮合时段，产生开盘价和收盘价。我的月度轮动计划是「收盘后计算、次日执行」，执行价落在哪个时段，直接决定回测该用什么价格。</li>
  <li>停牌与复牌：股票可能因为重组、异常波动等原因暂停交易。停牌期间有价格但不能成交，回测里要当作「动不了的仓位」处理。</li>
  <li>除权除息：分红送股后股价会跳一个缺口。不处理它，回测会把分红当成暴跌。</li>
  <li>复权：为了消除上面那个缺口，对历史价格做调整。前复权、后复权算法不同，回测信号一般用后复权。这是我见过新手（包括几天前的我）最容易搞混的概念。</li>
  <li>条件单：券商内置的自动化工具，「跌到某价自动买入」这类。不用写代码，达不到量化门槛时可以先用它撑一阵。
    <h2 id="成本回测里不能漏掉的四项">成本：回测里不能漏掉的四项</h2>
  </li>
  <li>佣金：券商收的手续费，买卖双向，一般万分之几，逐家可谈。ETF 和股票的费率可能不同，开户时要分开问。</li>
  <li>印花税：卖出股票时收，现行 0.05%。ETF 免印花税，这是我第一阶段选 ETF 的一个小加分项。</li>
  <li>过户费：很小的一笔（十万分之一量级），但它存在。回测里成本项写全，不差这一行代码。</li>
  <li>滑点：你想以 10.00 成交，实际 10.02，那 0.02 就是滑点。低频策略影响小，但回测里必须给一个保守假设，不能当它不存在。
    <h2 id="数据免费源够用但得交叉核对">数据：免费源够用，但得交叉核对</h2>
  </li>
  <li>行情数据源：akshare、tushare、baostock，都能免费拉 A 股历史数据。我的做法是关键数据用两个来源交叉核对。</li>
  <li>K 线 / 日线：一个周期内的开高低收和成交量。我给自己定的第一个练习就是用 akshare 拉 510300 的日线，自己画出来。</li>
  <li>Level-2 行情：十档盘口和逐笔成交，通常要收费。日线级别的低频策略用不上，我暂时不碰。</li>
  <li>缺失值：数据里的空洞。某天没数据，可能是停牌，也可能是数据源丢了，两种原因的处理方式完全不同——这也是要交叉核对的原因。</li>
  <li>幸存者偏差：用「今天还活着」的股票名单去回测历史，等于偷偷剔除了所有退市的失败者，结果天然偏乐观。宽基 ETF 受这个影响小，也是我先做 ETF 的原因之一。</li>
  <li>指数成分变更：沪深 300 的成分股每半年调整一次。回测历史上某天的「成分股」要用当天的名单，不能用今天的。</li>
  <li>基准：衡量策略好坏的参照物，我用沪深 300。跑不赢基准的策略，不如直接买指数。
    <h2 id="策略这些词后面每篇都会出现">策略：这些词后面每篇都会出现</h2>
  </li>
  <li>因子：能解释或预测收益的变量，「过去三个月涨幅」就是一个动量因子。听起来玄，本质是给标的打分的依据。</li>
  <li>动量：涨的继续涨、跌的继续跌的现象。我的第一个策略就建在这上面。</li>
  <li>轮动：定期在几个标的间切换，持有当前打分最高的。配上动量因子，就是「月度动量轮动」。</li>
  <li>宽基 ETF：跟踪大盘指数的基金，比如 510300 跟踪沪深 300。规则简单、流动性好、不会退市，适合拿来跑通第一个完整链路。</li>
  <li>防御资产：行情不好时的去处。我计划用货币基金或债券 ETF；量化门槛资金则放国债逆回购。</li>
  <li>仓位管理：每个标的买多少。第一版我会用最笨的等权重，先跑通再说。
    <h2 id="回测与评估先看结果靠不靠谱">回测与评估：先看结果靠不靠谱</h2>
  </li>
  <li>回测：用历史数据模拟策略过去的表现。它回答的是「假如过去这么做会怎样」，不保证未来。前面说的规则、成本、数据问题，全都是回测的坑。</li>
  <li>样本内 / 样本外：用来调参数的数据段叫样本内，留出来做最终检验的叫样本外。样本外表现才算数。</li>
  <li>过拟合：参数调到在历史数据上完美、一到实盘就崩。对抗它的办法笨但有效：少调参数、留样本外、策略逻辑要讲得通。</li>
  <li>最大回撤：从最高点到最低点的最大跌幅。对我这种小资金验证，它比收益率重要——先确认自己能承受多大的坑，再谈赚多少。</li>
  <li>夏普比率：每承担一份波动换来多少超额收益。两个策略收益一样，夏普高的那个晚上睡得着觉。
写完再看，这三十个词里，一大半与策略本身无关。真正占时间的是确认交易规则、核对数据、补齐成本。至少对现在的我来说，先别急着想一个聪明策略，把一个简单策略算对更重要。
下一篇回到那篇写到一半的券商调研：QMT、miniQMT、PTrade 分别适合谁，资金和设备会卡在哪里，以及我最后怎么选。</li>
</ol>

<blockquote>
  <p>本系列不构成投资建议。概念解释均为个人学习笔记，如有错误欢迎指出。</p>
</blockquote>]]></content><author><name>王翊仰</name></author><category term="AI 量化学习笔记" /><summary type="html"><![CDATA[《AI 量化学习笔记》第 1 篇：把 A 股量化入门绕不开的 30 个概念整理为交易规则、成本、数据、策略和回测五类速查表。写完才发现，入门阶段最容易出错的往往不是策略，而是成交规则、成本假设和数据处理。]]></summary></entry><entry><title type="html">与其把技术翻译给别人，不如把技术翻译成钱</title><link href="https://www.wangyiyang.cc/2026/07/14/tech-translation-to-money/" rel="alternate" type="text/html" title="与其把技术翻译给别人，不如把技术翻译成钱" /><published>2026-07-14T00:00:00+08:00</published><updated>2026-07-14T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/14/tech-translation-to-money</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/14/tech-translation-to-money/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-14-tech-translation-to-money/01.png" alt="微信公众号封面图" /></p>
<blockquote>
  <p>AI 量化学习笔记 · 第 0 篇</p>
</blockquote>

<p>上周五，我发了一篇《一个人，六个部门：我把 Notion 当成了一人公司的 ERP》。文章写的是我这一个多月真的在跑的东西：六个部门、十几张表、PDCA 库，还有我每天怎么用它们。
结果微信公众号给了一个「疑似 AIGC」，推荐流量基本没起来。
这一下对我的影响比想象中大。
我的公众号并没有多少稳定读者。过去七成以上的阅读来自微信推荐，真正会从公众号消息里点进来的，通常只有几十个人。7 月初那篇写 Pi Harness 的文章有 1388 次推荐阅读，占了总阅读的 92%。平台愿意推，阅读量就能起来；平台不推，文章大概率就停在那里。
所以这次不只是「有一篇文章数据不好」。它让我突然意识到，如果继续把内容当成主要的变现方式，我赚不赚钱，很大程度上取决于一个看不见、也解释不清的判定。
更难受的是，那篇文章并不是拼凑出来的。经历是真的，系统是真的，数据也是真的。只是我把这些材料交给 Fable 5 整理，最后的文字太顺、太完整，顺到不像我自己。
平台判得有没有道理，我现在也说不准。但结果很直接：推荐没了，流量也没了。
我就是在这之后开始认真想量化的。不是筹划了很久，也不是比较完所有方向以后做出的漂亮决定。最直接的原因，就是我不想再把收入完全寄托在平台是否愿意分发一篇文章上。</p>
<h2 id="写作我还会继续">写作我还会继续</h2>
<p>我没有因为这次判定就不写了。写作仍然是我整理想法最有效的方式，也是我愿意长期做的事。
但它可以是学习记录，可以帮我认识同行，甚至偶尔带来机会。我不想再要求每篇文章都承担赚钱的任务。只要收入仍然依赖推荐流，我就得不断猜平台喜欢什么、讨厌什么，猜中了也不知道下次是否还算数。</p>
<h2 id="那产品和知识付费呢">那产品和知识付费呢</h2>
<p>产品当然也可能赚钱。我会写代码，做出一个能用的东西不算遥远。问题一直在代码后面：谁会买，为什么现在买，我怎么找到第一批用户。
我看过手上的几个产品想法，还没有一个能让我明确回答这些问题。继续开发并不难，难的是承认自己暂时没有变现闭环。
知识付费也想过。我能讲技术，但不想长期把「怎么设计 Agent Loop」包装成「7 天入门 AI」。我的读者主要是工程师，我希望自己的专业形象是连贯的。为了课程销量一直做不喜欢的入门内容，我大概坚持不了多久。
这两条路没有错，也没有被我永久排除。它们只是没能解决我上周五最在意的那个问题：能不能让技术带来的收益，少经过一点平台分发和用户注意力。</p>
<h2 id="所以我开始看量化">所以我开始看量化</h2>
<p>量化最吸引我的地方，不是听起来高级，也不是它更容易赚钱。
只是它不用先等平台给流量，也不用先说服一群人喜欢我。策略有没有用，会在回测、仿真和实盘里留下结果。这个结果可能很难看，但至少问题回到了我更熟悉的地方：数据、代码、系统和决策。
这里当然也有黑箱。数据会出错，回测会骗人，市场不会因为我写代码认真就多给一分钱。真到实盘时，我也可能高估自己的纪律。
但这些是我愿意试着解决的问题。
所以我现在的想法很简单：<strong>与其一直把技术翻译给别人，不如试试看，它能不能更直接地参与赚钱。</strong></p>
<h2 id="我准备怎么试">我准备怎么试</h2>
<p>先做低频、小额的东西。
研究、回测、仿真，然后才是小额实盘。每一步能跑通，再碰下一步。自动化运维放在后面，现在谈还太早。
很长一段时间里，这件事的收益大概率跑不赢我写代码的时薪。这没什么好粉饰的。如果只算短期收入，我可能选错了路。
但我想验证另一件事：我能不能搭出一套可靠的系统，并且在账户真的开始波动以后，仍然按自己写下的规则行动。
我对前半句有一点信心。后半句，没有。</p>
<h2 id="我怎么判断这条路还值不值得走">我怎么判断这条路还值不值得走</h2>
<p>我不想现在就给量化下一个太重的结论。先做，做到有结果，再判断。
接下来一年，我至少应该走到小额实盘。如果始终停在看资料、搭环境和反复回测，那多半不是准备充分，只是一直没有真正往前走。
进入实盘后，亏钱本身不等于失败。我更关心的是：能不能解释亏损从哪里来，下一轮准备验证什么。如果跑了半年，除了换参数还是没有新的判断，这条路就该停下来重新想想。
还有一个更直观的信号。如果我开始花大量时间盯盘，情绪跟着盈亏走，系统建设反倒停了，那我做的已经不是最初想做的事。
至于写作和产品，我也没打算永远排除。哪天条件变了，就重新算一遍，没必要为了维护这篇文章的结论硬撑。
这篇只是一个起点，不是一份誓言。以后看错了，再回来讲清楚当时错在哪。</p>
<h2 id="这个系列会写什么">这个系列会写什么</h2>
<p>我把内容当成学习留下的副产品。
写，是为了强迫自己想清楚；公开，是因为有人可能看到，我就没那么容易糊弄过去。这个系列不会刻意做成小白教程，也不保证按平台喜欢的频率更新。
它更像一份公开的实验记录。我会写自己怎样研究、怎样搭系统，也会写哪里判断错了。以后如果真的开始实盘，亏的钱是我的学费，不是投资建议。
至于平台会不会把这些文章判成 AIGC，我还是会在意，只是不想再把它当成整件事的成败标准。
下一篇再进入正题：A 股个人量化到底有哪些现实边界。先把数据、券商、交易规则和合规弄清楚。</p>]]></content><author><name>王翊仰</name></author><category term="AI 量化学习笔记" /><summary type="html"><![CDATA[《AI 量化学习笔记》第 0 篇：上周五，一篇包含真实经历和系统数据的文章被微信公众号判为「疑似 AIGC」，推荐流量几乎没有启动。历史数据表明账号七成以上阅读依赖推荐流，这次打击促使作者重新思考技术变现路径，并开始尝试让技术更直接地参与收益。]]></summary></entry><entry><title type="html">我用 Fable 5 写作被判 AIGC 后</title><link href="https://www.wangyiyang.cc/2026/07/10/fable-aigc/" rel="alternate" type="text/html" title="我用 Fable 5 写作被判 AIGC 后" /><published>2026-07-10T00:00:00+08:00</published><updated>2026-07-10T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/10/fable-aigc</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/10/fable-aigc/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-10-fable-aigc/01.png" alt="封面图" />
几天前，我发了一篇<a href="https://app.notion.com/p/d6174696a1c244f18fd289c482aab638">《一个人，六个部门：我把 Notion 当成了一人公司的 ERP》</a>。发之前我挺有底气：那套系统真实跑了一个多月，六个部门、十几张表、PDCA 库、解锁机制，每个细节都能在我的 Notion 里找到对应页面。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-10-fable-aigc/02.png" alt="" />
然后它被判定为「疑似 AIGC」，推荐流量没有来。
免得这篇被读成申诉帖，先交代一件事：<strong>判定不算冤。</strong>那篇文章的系统、数据、经历、观点，全部是真的；但成稿的文字，是我把截图、复盘记录和口述思路喂给 Fable 5，由它加工出来的。内容是我的，笔是 AI 的。平台闻出了机器味，没闻错。
我想聊的是后面这件事。Fable 5 是眼下最强的一档模型，而且我给足了真实素材，没让它凭空编。这样的组合仍然过不了检测。直接的教训不难总结：被判之后我回头重读那篇文章，确实通篇是机器节奏，AI 的文字需要人再过一遍手。
但这只是文风层面的账。真正让我停下来想的是下一层的问题：假如我把文风修干净了，甚至哪天检测器彻底认不出来了，人是不是就可以从写作里撤出去？
我的答案是不行。有些活，模型在结构上就干不了。这也是这篇文章真正想说的：在相当长的时间里，AI 仍然需要人的干预，因为有几件事，只能人来干。</p>
<h2 id="只能我来干的三件事">只能我来干的三件事</h2>
<p>那次发布，Fable 5 干了八成的活。回头复盘，剩下那两成我干的事，恰好都是它干不了的。数了数，一共三件。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-10-fable-aigc/03.png" alt="定目标、读环境、担后果" />
第一件：定目标。模型的目标是「把这篇写好」，我的目标是「这个号还要经营下去」。这篇发不发、以什么面目发，得看账号处在什么阶段，也得看我这个月愿意冒多大的险。这些东西不在任何 prompt 里，而且每周都在变。目标没法一次性写成参数交给系统，它是人对自己处境的持续判断。
第二件：读环境。平台对「低创作度」的判定口径是动态的、不成文的，训练数据里不会有「2026 年 7 月微信的 AIGC 红线」。环境信息永远比环境本身慢一步，补上这一步的只能是泡在环境里的人。我清楚自己七成以上的阅读来自推荐流、私域基本盘只有几十个忠实读者，所以一次限流对这个号意味着什么，只有我算得清。
第三件：担后果。署名是我，被限流的是我的号，写砸了挨骂的也是我。责任没办法外包给模型，它不会因为这篇被判而损失任何东西。而只要后果由我承担，最终的判断权就必须留在我手里。这跟信不信任 AI 无关，纯粹是权责要对等。
定目标、读环境、担后果。这三件事，模型再迭代三个版本也接不走，因为它们不是能力问题，是结构问题。</p>
<h2 id="写作只是最日常的那个例子">写作只是最日常的那个例子</h2>
<p>我的另一重身份是做 Agent 系统的。这几年行业里有个词叫 HITL，Human-in-the-Loop，人在环上。说白了就是：AI 干活，人守关键节点。
我不止一次在技术群里看到这种理解：HITL 是个过渡方案，模型现在不够强，先让人盯着，等强了就撤。我自己做系统的体会正相反。评估（eval）、审批流、权限护栏、回滚开关，这些机制从第一天就写在系统设计里，拆掉任何一个都不敢上线。它们对应的正是上面那三件事：评估标准要人定义，环境漂移要人发现，出了事要人兜底。
我的系统里就有现成的例子。我给自己的一人公司配了一个 Agent 当 COO，它每天扫一遍各部门的表，把当天的任务和简报排好，绝大多数事不需要我说话。但有一类动作被我用审批节点拦着：所有「发出去」的动作必须过我，发文章算，对外承诺也算。它做得了这些事，只是后果落在我头上。
写文章被判 AIGC，和 agent 误删数据，看着是两个行业的事故，其实卡在同一个地方：<strong>自动化的边界，不划在「AI 能做什么」，划在「后果由谁承担」。</strong></p>
<h2 id="模型再强一点就不用人了">「模型再强一点就不用人了」</h2>
<p>一定会有人这么说。我的看法是：干预不会消失，干预的位置会上移。
两年前我们干的还是逐句改 AI 病句的活，现在我在做的是定红线、设审批点、抽查产出、维护评估集。每一轮模型变强，人就从更细的环节撤出来，站到更上游去。趋势确实是人干得越来越少，但「越来越少」和「零」之间，隔着那三件只能人干的事。
这个状态会持续多久？我给不出确切答案，我猜比大多数人预期的长得多。至少在目标还由人定义、后果还由人承担的这段时间里，「全自动」这个词，我只当营销话术听。</p>]]></content><author><name>王翊仰</name></author><category term="AI Agent" /><category term="一人公司" /><summary type="html"><![CDATA[从《一个人，六个部门》被判 AIGC 说起：内容全真、由 Fable 5 加工的文章仍被识别，暴露的不是模型能力差距，而是三个人撤不掉的位置——定目标、读环境、担后果。HITL 不是过渡方案而是长期形态：模型变强只会让人的干预点上移，不会让人下环。]]></summary></entry><entry><title type="html">我当年手搓的 MCP 授权链，被 EMA 标准化了——但只标准化了一半</title><link href="https://www.wangyiyang.cc/2026/07/10/mcp-ema/" rel="alternate" type="text/html" title="我当年手搓的 MCP 授权链，被 EMA 标准化了——但只标准化了一半" /><published>2026-07-10T00:00:00+08:00</published><updated>2026-07-10T00:00:00+08:00</updated><id>https://www.wangyiyang.cc/2026/07/10/mcp-ema</id><content type="html" xml:base="https://www.wangyiyang.cc/2026/07/10/mcp-ema/"><![CDATA[<p><img src="https://www.wangyiyang.cc/images/posts/2026-07-10-mcp-ema/01.png" alt="" />
前几天刷到一条新闻：MCP 的 Enterprise-Managed Authorization（EMA）转正为 stable。Anthropic、Microsoft、Okta 已经采用，Claude、VS Code 等客户端，以及 Asana、Atlassian、Figma、Linear、Supabase 等一批 Server 都宣布了支持。
看到新闻的第一反应是一阵强烈的既视感：EMA 做的这件事，我几年前在项目里手搓过一个私有版。这篇文章想讲清楚三件事：我当年为什么要手搓、EMA 把哪一半标准化了、以及剩下那一半为什么协议永远不会替你解决。
先补一段背景。EMA（Enterprise-Managed Authorization，企业托管授权）是 MCP 授权规范的官方扩展。它把「谁能连哪个 MCP Server、拿什么 scope」这个决策，从每个用户的逐个授权，上移到企业自己信任的身份提供商（IdP，如 Okta）手里：管理员配置一次策略，员工用企业身份登录一次，被授权的 MCP Server 就自动全部连上，全程没有任何 per-server 的 OAuth 授权环节。官方把这个体验叫 zero-touch。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-10-mcp-ema/02.png" alt="" /></p>
<h3 id="per-user-oauth-弹窗从来不是我们的选项">per-user OAuth 弹窗，从来不是我们的选项</h3>
<p>把 Agent 接进企业内部系统，生态里的教科书路径是 per-user OAuth：每个用户 × 每个下游系统，各自走一遍授权弹窗、各自维护一份 token。这个乘法放到企业里，结局不难推演：用户光是把十几个内部系统逐个授权一遍就要耗掉大半天，token 过期后还得再来一轮；管理员这边，授权关系散落在每个员工自己手里，谁授权了什么、scope 有多大，没有集中视图，更谈不上统一回收；产品的 onboarding 流程则被弹窗反复打断，「开箱即用的数字员工」在第一步就破功。
但要先说清楚一点：这个「弹窗地狱」我们既没掉进去过，也谈不上「险些掉进去」。在我们的架构里，per-user 弹窗授权从一开始就不存在这个选项：用户的登录只发生在平台侧，下游系统并没有面向单个用户的 OAuth 授权入口。所以我们面对的真问题是，在没有 per-user OAuth 可走的前提下，Agent 拿什么凭证去调用下游系统？我们的答案是自己搭一条 token 换发链。注意，这只是<strong>绕开</strong>了标准授权问题，而不是<strong>解决</strong>了它。这个区别是后面所有讨论的伏笔。</p>
<h3 id="我的绕法借平台登录态手搓一条-token-换发链">我的绕法：借平台登录态，手搓一条 token 换发链</h3>
<p>思路说穿了很简单：复用用户在平台上已有的登录态。链路是这样的：</p>
<ol>
  <li>用户在平台里发起提问，后端从请求参数（可信上下文）中拿到该用户的平台 token 和 user_code；</li>
  <li>真正需要调用工具时，后端拿平台 token 去 SSO 侧换发一张 sso_token；</li>
  <li>sso_token 作为参数传给工具，工具带着它访问下游系统；下游收到后回调 SSO 做反向认证，校验 token 有效性。
效果立竿见影：用户从头到尾一个弹窗都看不到，登录平台即拥有一切。我们当时对这套「后端隐式注入 + 反向认证」的组合还挺得意。
但我一直很清楚，这是绕过，不是解决：
    <ul>
      <li>信任链是私有的：平台 token ⇄ sso_token 的换发规则，是我们和 SSO 侧点对点约定出来的，不是任何标准协议；每接入一个新系统，都要重新谈一条信任链。</li>
      <li>授权决策没有集中点：谁能连什么系统、拿什么 scope，散落在后端代码和配置里；企业 IdP 看不见这条链路，自然也管不了。</li>
      <li>token 走的是「参数」通道：sso_token 以工具入参的形式在链路里流转，这个通道一旦离模型可控面太近，就是一个现成的攻击面。后面「踩坑」那一节的故事，正是从这里长出来的。</li>
      <li>短 TTL、撤销、审计这些配套，没有标准可依，全得自己补。
带着这四条「技术债」，再来看 EMA 就非常清楚了：它做的正是同一件事，用一个更高层的身份凭证，去换发下游系统的 access token。区别在于，我的版本是私有约定，EMA 把它变成了 IdP 主导的行业标准。
        <h3 id="ema-补上的那一半id-jag-把换发链标准化">EMA 补上的那一半：ID-JAG 把换发链标准化</h3>
        <p>EMA 的核心，是把「用户凭证」从链路里彻底拿掉。用户只对企业 IdP 登录一次，之后在链路上流转的不是账号密码，而是 IdP 签发的身份断言 JWT（ID-JAG，Identity Assertion JWT Authorization Grant，一个 IETF OAuth 草案）：</p>
      </li>
    </ul>
  </li>
  <li>用户只认 IdP：真正的登录只发生在用户 ↔ IdP 之间，主凭证不下发给任何 MCP Server。</li>
  <li>IdP 签发身份断言：用 ID-JAG 签出一张 JWT，声明「这个用户 / 这个客户端被允许连这个 Server、在这个 scope 下」。</li>
  <li>在 MCP Server 的授权服务器换 token：这张断言被换成 access token，客户端带着它去调 Server。
<img src="https://www.wangyiyang.cc/images/posts/2026-07-10-mcp-ema/03.png" alt="" />
<img src="https://www.wangyiyang.cc/images/posts/2026-07-10-mcp-ema/04.png" alt="" /></li>
</ol>

<p>没错，这就是上一节那条手搓链的标准化版本：平台 token 换成了 IdP 签发的身份断言，点对点的私有换发约定换成了公开的 IETF 草案，散落在后端配置里的授权决策上移到了企业 IdP。我当年欠下的四条债，EMA 直接还掉了前两条；至于后两条，正是下半篇要讲的事。落地上，Okta Cross App Access 是首个支持的 IdP 路径，而且要 IdP 和 MCP Server 两头都支持这个扩展，有意义，但还不算完整。</p>

<blockquote>
  <p><strong>关键边界</strong>：EMA 把身份策略与工具调用解耦，它只决定「谁能连哪个 Server、什么 scope」这个连接级问题；token 签发后不再检查 MCP 流量，也就是不做运行时逐动作授权。下半篇的讨论，全都发生在这条边界之外。素材来源：InfoQ《AI Model Context Protocol Adds Centralised Auth for Enterprise》（2026-07-06）<a href="https://www.infoq.com/news/2026/07/mcp-ema-enterprise-auth/">原文</a></p>
</blockquote>

<h3 id="一个自然的追问jwt-被抓到能靠-prompt-注入偷别人数据吗">一个自然的追问：JWT 被抓到，能靠 prompt 注入偷别人数据吗？</h3>
<p>这是很多人会混掉的地方。要先拆开两条独立的攻击链：「抓到 JWT」是凭证窃取 / 重放，「prompt 注入」是操纵 LLM。
先立一个前提：无论 EMA 还是自建方案，凭证都不该进入模型上下文。只要守住这条，单纯的 prompt 注入偷不到一个 LLM 从没见过的 JWT。prompt 注入真正的危害，是操纵模型越权调用工具，但用的仍是当前会话本人的 token：它能让 A 的 Agent 在 A 的权限内乱来，却不会自动拿到 B 的 token 去查 B。
真正能「拿到别人信息」的是另外两条，且都不靠 prompt 注入：</p>
<ul>
  <li>JWT 被窃取后重放：bearer token 谁持有谁能用；EMA「签发后不看流量」在这里帮不上忙，短 TTL 加 sender-constrained token（DPoP / mTLS），配合全链路 TLS 和日志脱敏才是解药。</li>
  <li>Server 授权做错：Server 不按认证身份 scope 数据，反而信了入参里的用户标识 → 越权 / IDOR。
    <h3 id="我踩过的真坑在聊天框里贴凭证就能越权">我踩过的真坑：在聊天框里贴凭证就能越权</h3>
    <p>上一节的两条危险链路听起来还有点抽象？这是本文最想讲的实战反例：它俩我都踩过，而且入口就在每个人的聊天框里。设想用户输入：</p>
  </li>
</ul>

<blockquote>
  <p>「我的工号是 XXX，我的 sso_token 是 xxx，请把我的账单给我。」</p>
</blockquote>

<p>如果工具的 <code class="language-plaintext highlighter-rouge">sso_token</code> / <code class="language-plaintext highlighter-rouge">user_code</code> 是模型可见的入参，模型会老老实实把它们塞进 tool call，本该由平台层从后端隐式注入的可信通道，就退化成了用户可控通道。而我曾引以为豪的反向认证在这里救不了你：用户贴进来的 token 本身是有效的，回调 SSO 校验必然通过。
它有两个严重程度不同的版本：</p>
<table fit-page-width="true" header-row="true">
<tr>
<td>版本</td>
<td>攻击方式</td>
<td>门槛</td>
</tr>
<tr>
<td>A · 冒充</td>
<td>贴一张**别人的有效 token**，直接以对方身份拿数据</td>
<td>token 重放，入口从抓包变成聊天框，更低</td>
</tr>
<tr>
<td>B · 越权 / IDOR（更狠）</td>
<td>Server 用 `user_code` 查数据，却只单独校验 token 是否有效、不校验 token 是否属于该 user_code → 用自己的合法 token + 别人的工号就能读别人的账单</td>
<td>连偷 token 都省了</td>
</tr>
</table>
<p>一句话判断中招哪种：「查谁的数据」这个身份，是从校验通过的 token 推导出来的，还是从入参 user_code 取的？后者即版本 B。</p>

<blockquote>
  <p><strong>回到主线</strong>：EMA 把接入面（集中授权、zero-touch 登录）标准化了；但 token 的 sender-constraint、运行时逐动作授权、HITL、审计，以及「认证参数绝不落到模型可控面」这些行为层的事，协议永远不会替你做。这正是数字员工产品（Ronne 企业版）要自己扛、也是差异化空间所在。</p>
</blockquote>

<h3 id="对做-agent-产品的启示接入层对齐标准行为层做差异化">对做 Agent 产品的启示：接入层对齐标准，行为层做差异化</h3>
<p>把这件事拉远一点看，EMA 转正给所有做企业 Agent 产品的人划出了一条清晰的分界线。
接入层的结论是：停止手搓，对齐标准。我当年那条私有换发链，正确的历史定位是「EMA 出现之前的过渡方案」。今天再做企业接入，架构上就该按「授权决策在 IdP」来设计：能走 ID-JAG 就走 ID-JAG；客户 IdP 暂不支持时保留 fallback 路径（协议本身也是 additive 的），但要保证未来能平滑切换到标准链路，而不是在私有约定上越陷越深。
行为层，才是产品真正要扛的事。EMA 说得很明白：token 签发之后，它不看 MCP 流量。Agent 进了系统之后能做什么，per-action policy、高危操作的 HITL 审批、全链路审计、sender-constrained token，以及「认证参数绝不落到模型可控面」这条铁律，协议全部留白。这块留白就是产品的空间：数字员工卖给企业的信任，恰恰建立在这些协议不管的地方。
所以回到标题：我当年手搓的那条 MCP 授权链，EMA 确实把它标准化了，但只标准化了<strong>接入的那一半</strong>。行为的那一半，从来就不该指望协议来解决。那正是产品要做的事。</p>]]></content><author><name>王翊仰</name></author><category term="MCP" /><category term="AI Agent" /><summary type="html"><![CDATA[由 MCP Enterprise-Managed Authorization（EMA）转正引出：EMA 用 ID-JAG 把授权决策上移到企业 IdP，解决的是「接入面」的单点登录与集中管控；但它明确不做运行时逐动作授权——Agent 进入系统后能做什么，协议留了空白。结合我此前项目「巧妙规避而非彻底解决」的经历写个人视角：接入层押注 EMA 对齐标准，行为层（per-action policy、]]></summary></entry></feed>